

Для анализа не всегда нужно загружать файлы в отдельную базу или настраивать сложную инфраструктуру. Если данные уже хранятся в CSV или Parquet, их можно открыть напрямую и выполнить SQL-запрос с помощью DuckDB. Как это сделать — рассказываем в статье.
Что такое DuckDB простыми словами
DuckDB — аналитическая система управления базами данных. Она поддерживает привычный SQL, позволяет выполнять запросы и делать расчеты.
В отличие от классических СУБД, DuckDB не требует отдельного сервера: ее можно запустить на компьютере и работать локально. DuckDB умеет обращаться непосредственно к файлам. Например, можно отфильтровать нужные записи, посчитать показатели или объединить несколько наборов данных.
Программу удобно использовать для быстрых исследований, проверки гипотез и разовых аналитических задач, когда нет необходимости создавать отдельные таблицы в базе данных.
Как начать работать с DuckDB
Разберем базовый сценарий работы с DuckDB — от первого запуска до анализа данных с помощью SQL.
Шаг 1. Устанавливаем DuckDB
DuckDB можно установить на компьютер как обычную программу. После запуска открывается интерактивная консоль: там можно писать SQL-запросы и сразу видеть результат.
Для проверки достаточно выполнить простую команду, например:
SELECT 1;
DuckDB вернет результат 1. Это означает, что программа запущена и готова к работе.
Шаг 2. Открываем файл
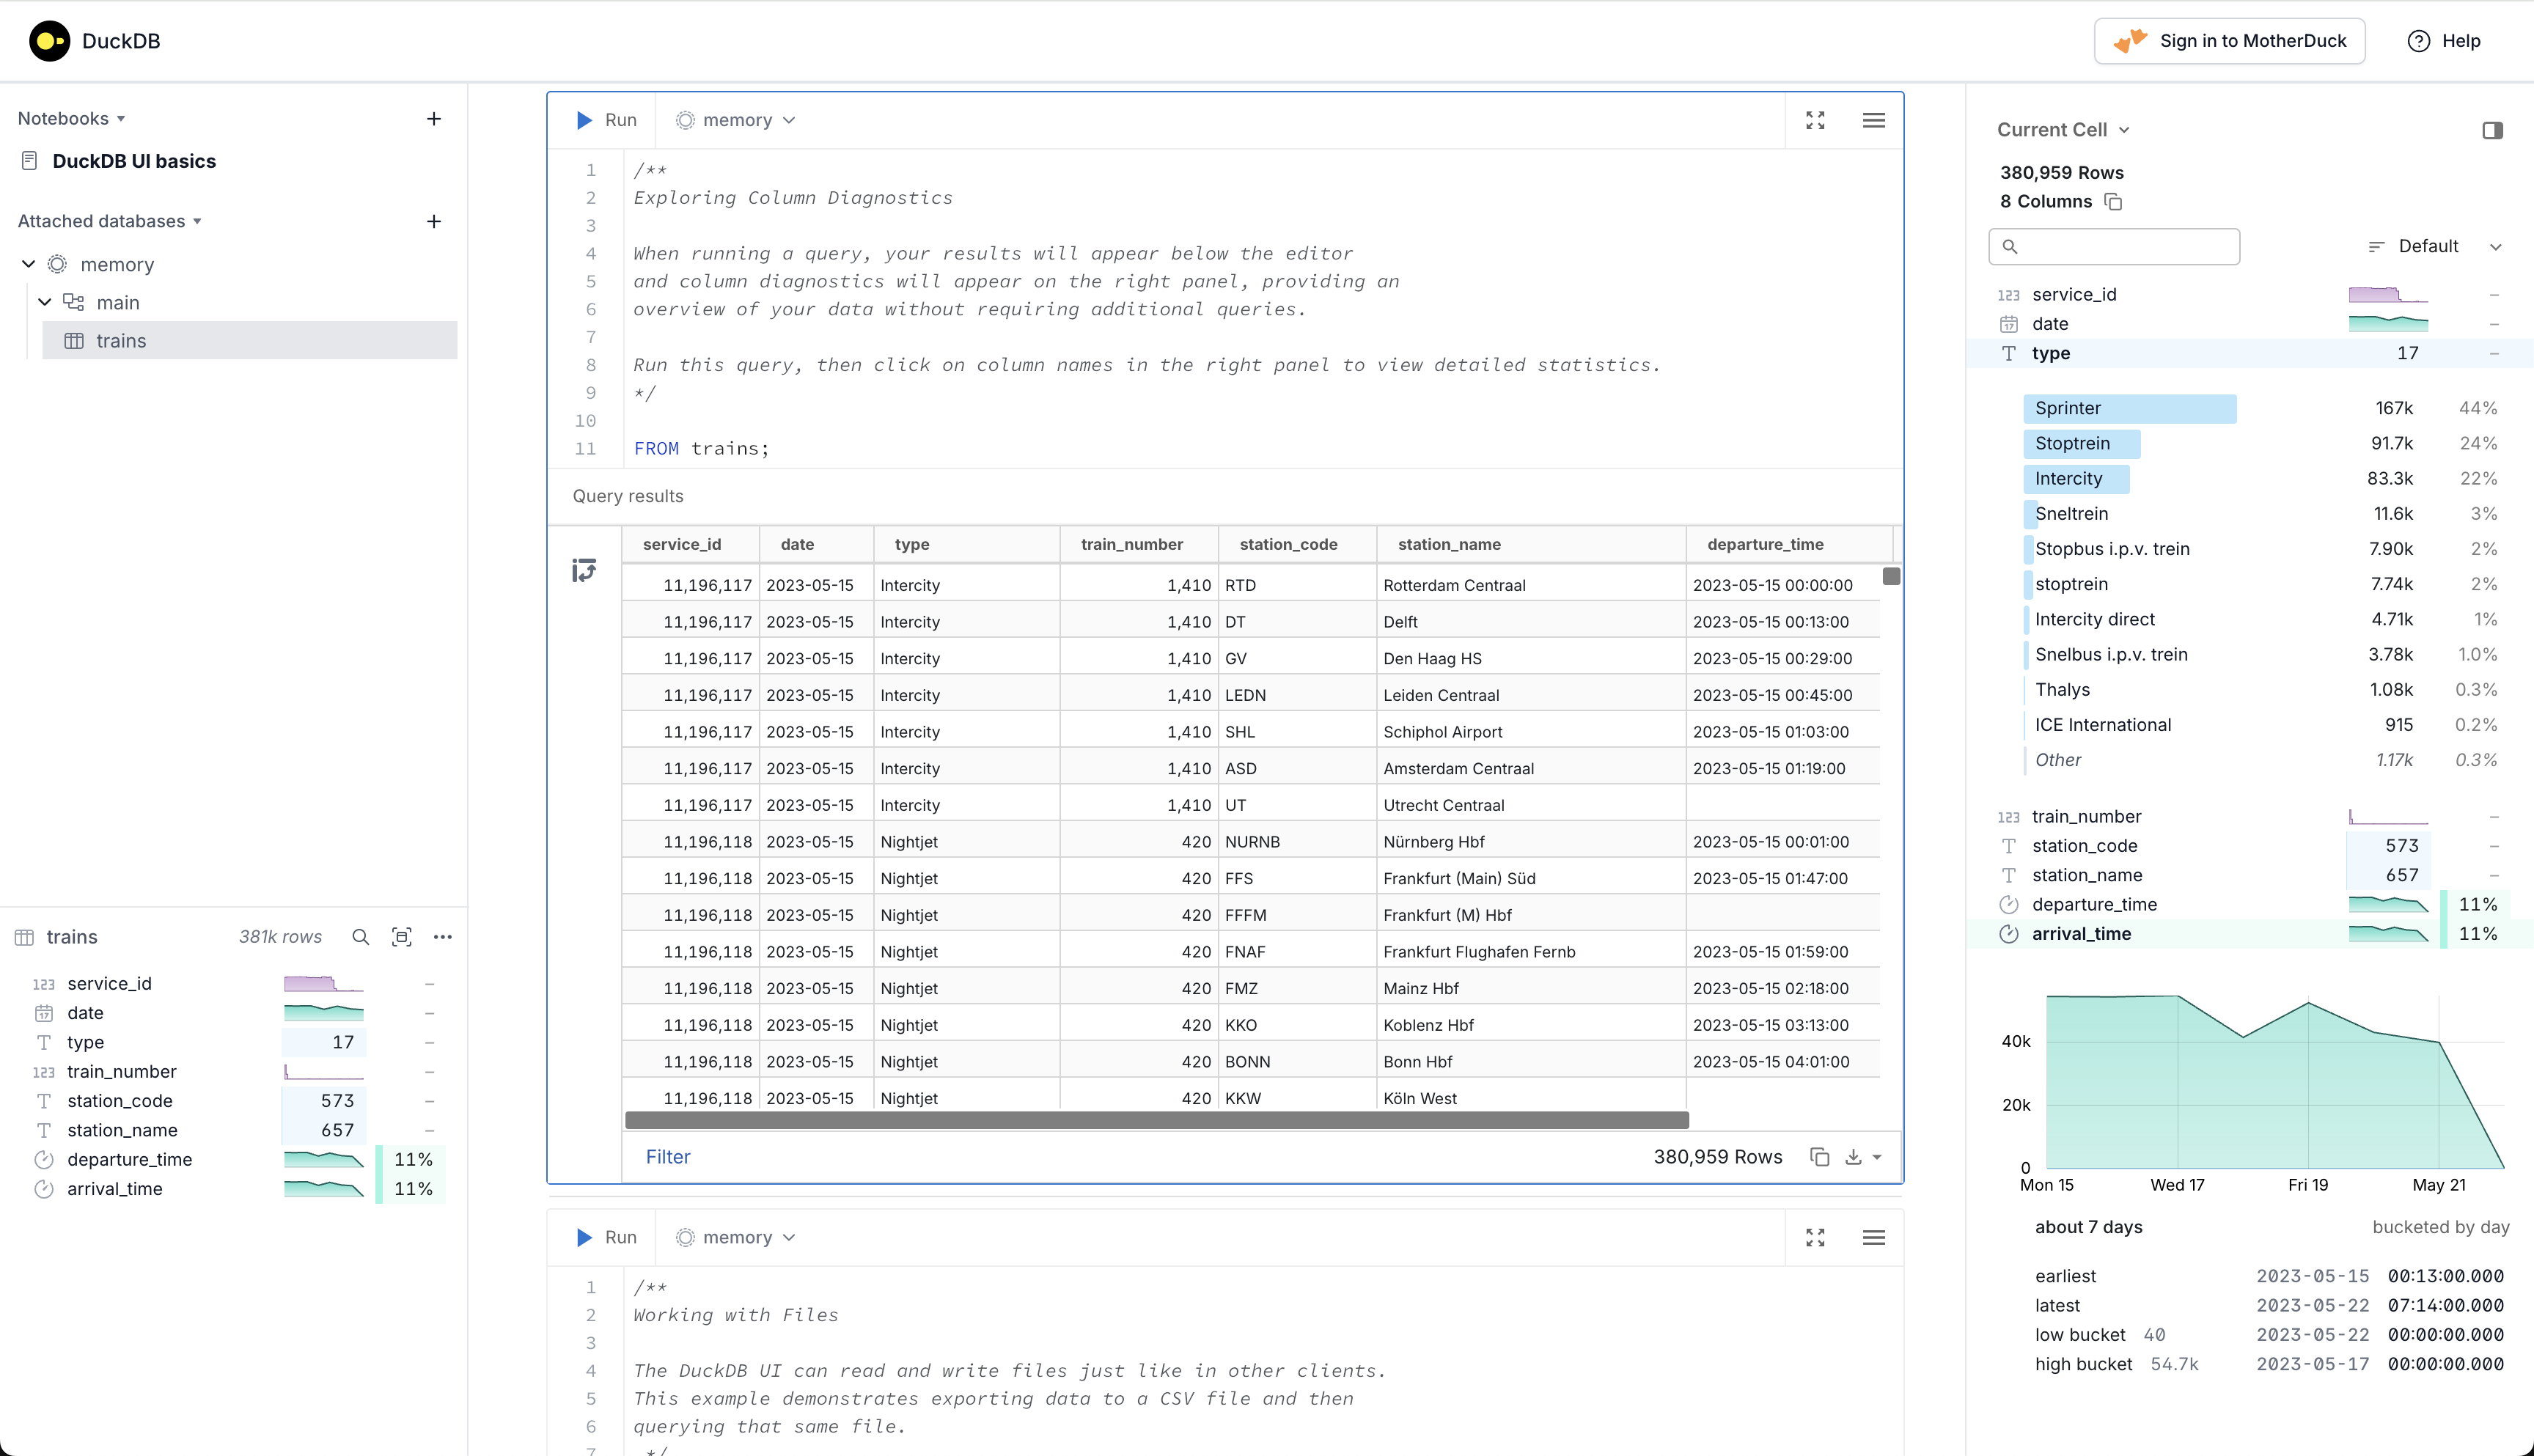
С помощью DuckDB можно открыть файл в формате CSV или Parquet. Программа позволяет обращаться к ним напрямую без предварительного импорта в базу.
Для начала попробуйте вывести первые десять строк, чтобы убедиться, что DuckDB правильно читает файл. Например:
SELECT *

FROM 'data.csv'

LIMIT 10;
Такой способ удобно использовать для первичного знакомства с датасетом: можно быстро посмотреть, какие столбцы есть в файле и с какими данными предстоит работать.
Шаг 3. Делаем SQL-запрос
После того как файл открыт, можно перейти к анализу данных. Для этого используют команды:
- SELECT — определяет, какие данные нужно получить;
- FROM — указывает файл, из которого берутся данные;
- WHERE — оставляет только строки, соответствующие заданному условию;
- ORDER BY — определяет порядок строк в результате;
- LIMIT — ограничивает количество результатов.
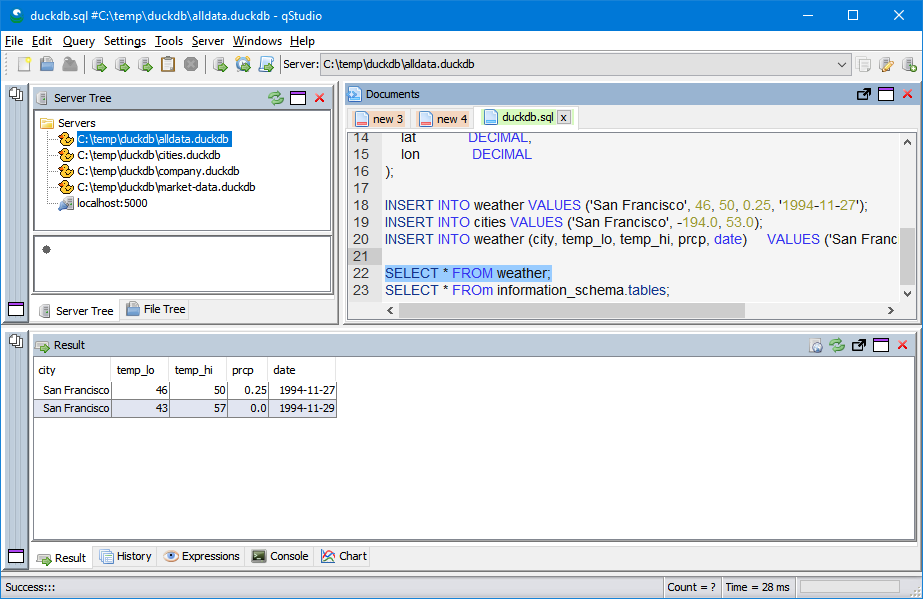
С помощью команд можно постепенно сузить набор данных и получить именно ту информацию, которая нужна для анализа. Например, здесь DuckDB вернет первые десять строк, которые соответствуют условию в WHERE, отсортировав их по значениям column_2.
SELECT column_1, column_2

FROM 'data.csv'

WHERE column_3 = 'value'

ORDER BY column_2

LIMIT 10;
Шаг 4. Считаем показатели
DuckDB можно использовать не только для просмотра данных, но и для расчета показателей. Для этого существуют команды:
- COUNT — посчитать количество записей;
- SUM — сложить значения в выбранном столбце;
- AVG — рассчитать среднее значение;
- MIN, MAX — найти минимальное и максимальное значение;
- GROUP BY — объединить записи в группы, чтобы посчитать показатели для каждой.
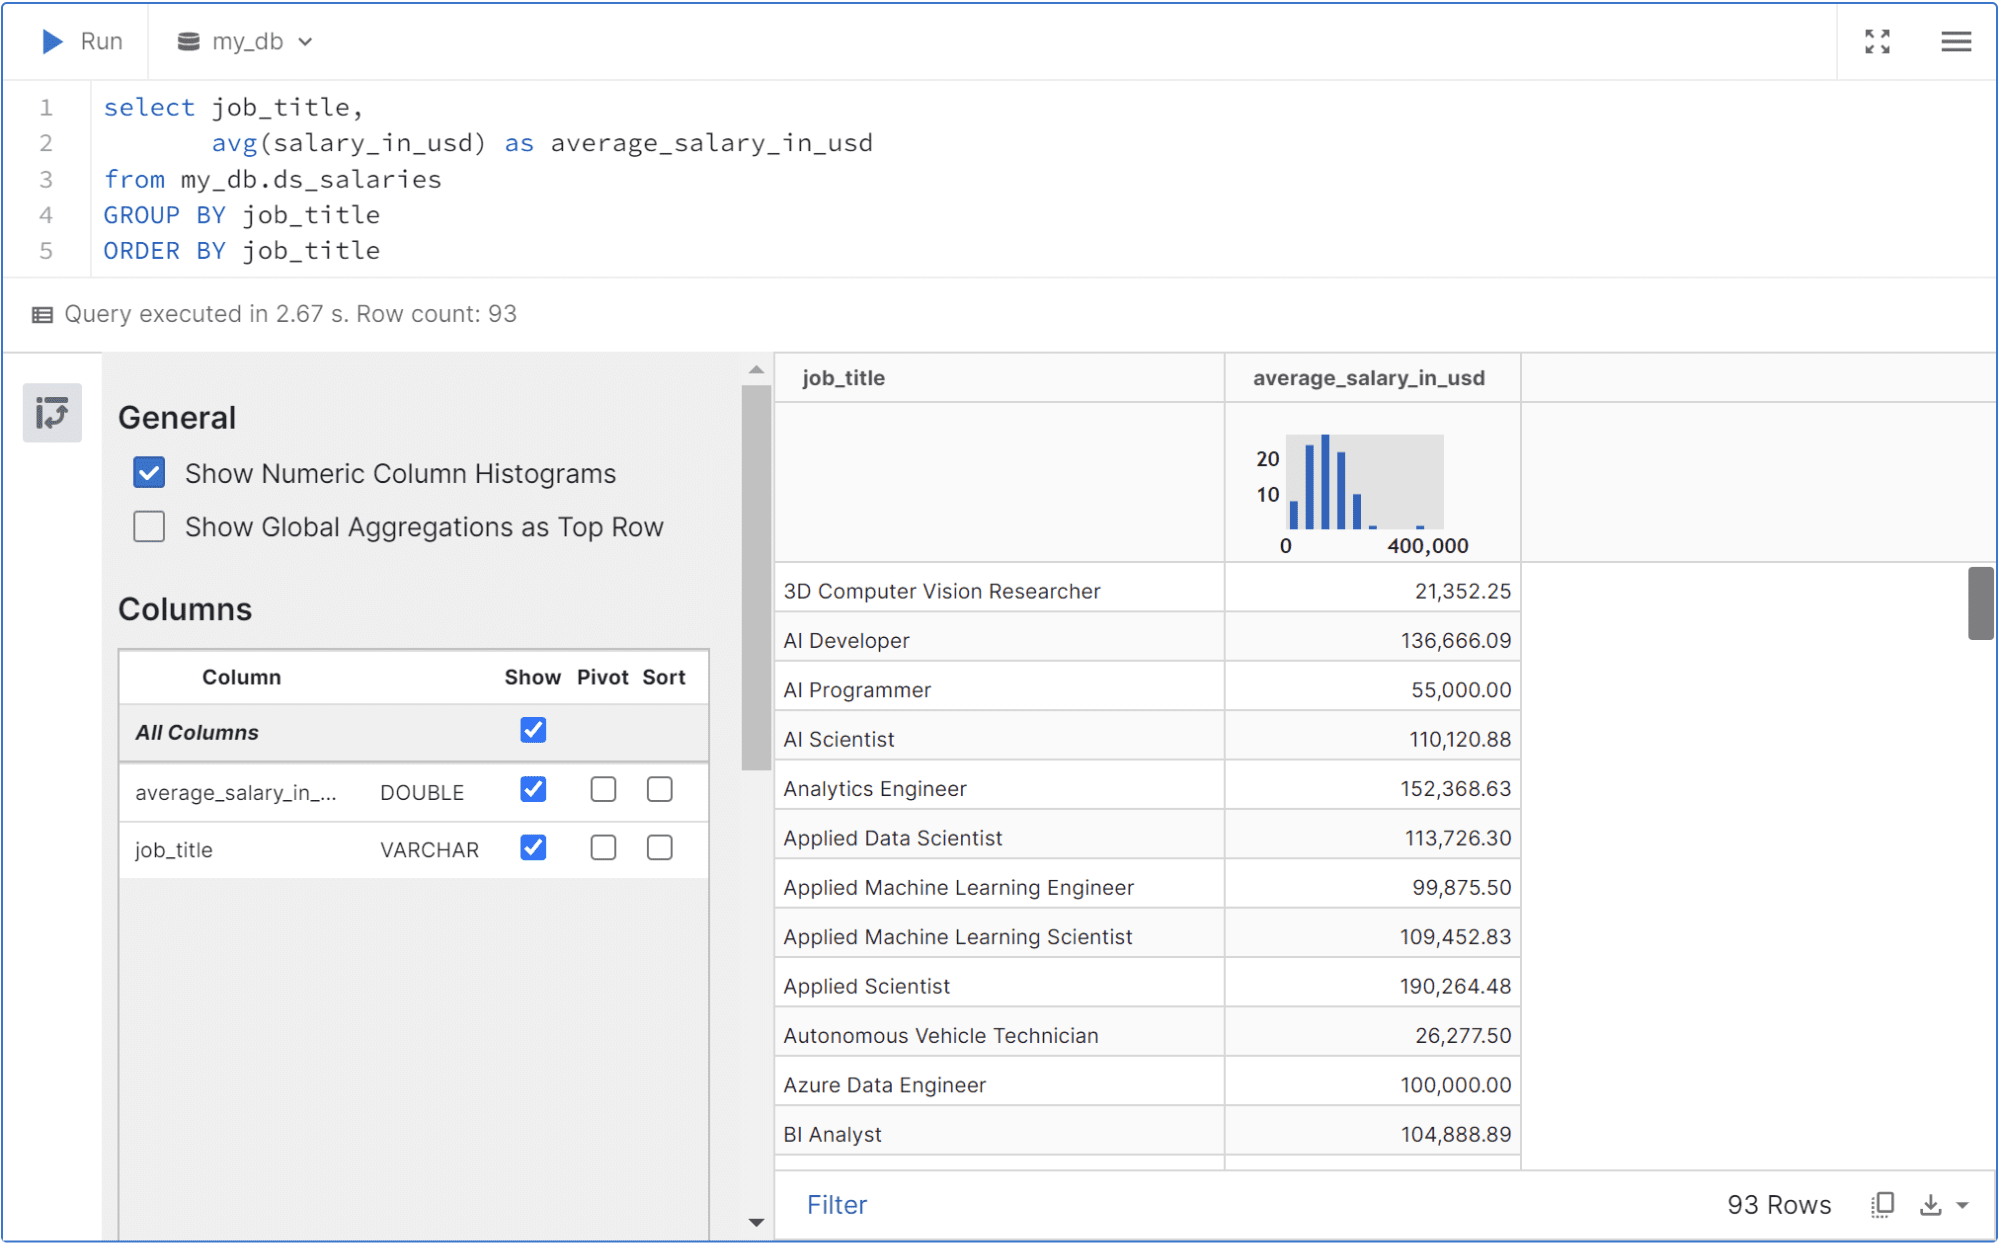
Эти команды подходят для самых разных задач и лежат в основе большинства аналитических SQL-запросов. Например, чтобы посчитать количество записей и среднее значение показателя отдельно для каждой категории, можно использовать запрос:
SELECT category, COUNT(*) AS total, AVG(value) AS average

FROM 'data.csv'

GROUP BY category;
DuckDB сгруппирует строки по значениям category, а также для каждой группы посчитает количество записей и среднее значение в столбце value.
Шаг 5. Объединяем данные из нескольких файлов
Часто бывает, что данные распределены по разным источникам. Например, в одном файле находятся заказы, а в другом — информация о клиентах. Чтобы связать записи, в них должно быть общее поле — идентификатор, уникальное значение, по которому можно определить конкретный объект.
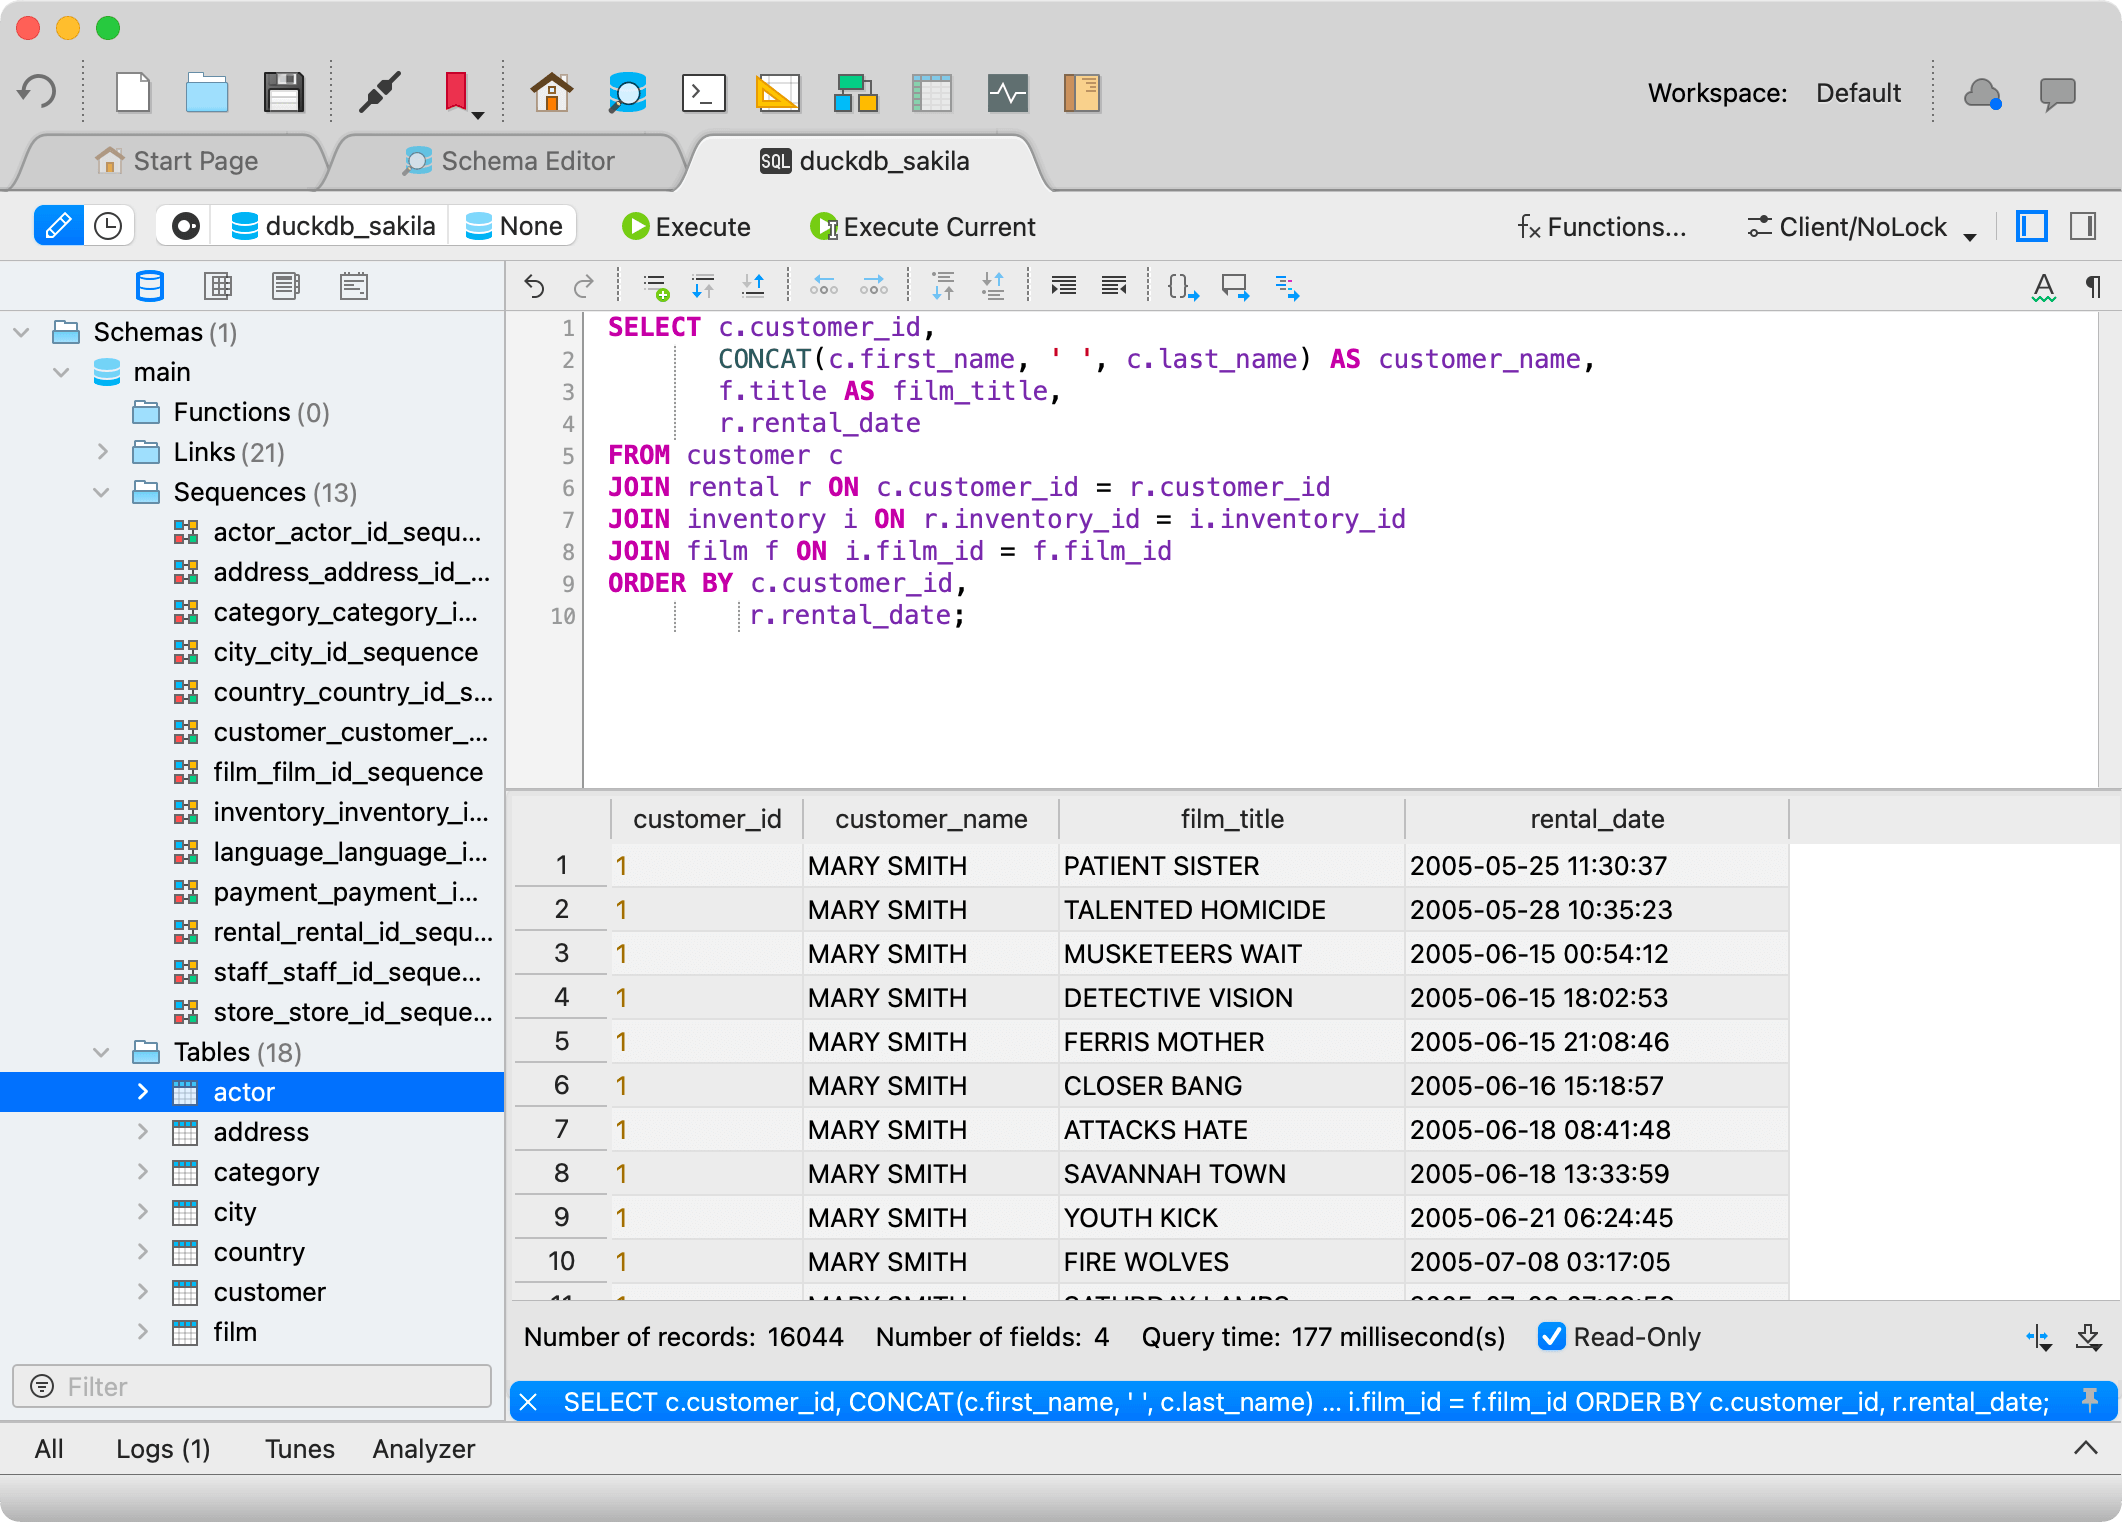
Например, здесь a и b — обозначения для двух файлов. Условие ON a.id = b.id указывает DuckDB, по какому общему полю нужно связать записи:
SELECT a.column_1, b.column_2

FROM 'data_1.csv' AS a

JOIN 'data_2.csv' AS b

  ON a.id = b.id;
Объединив данные с помощью JOIN, можно проводить более содержательный анализ: считать выручку по клиентам, сравнивать категории товаров, анализировать данные за разные периоды.
CSV и Parquet: какой формат выбрать аналитику
В аналитике чаще всего встречаются файлы двух расширений — CSV и Parquet. DuckDB поддерживает оба формата, но используются они для разных задач:
- CSV — простой текстовый формат. Занимает больше места и не хранит типы данных.
- Parquet — колонночный формат, который хорошо подходит для аналитики. Хранит структуру и типы данных.
Для больших наборов данных удобнее использовать Parquet: DuckDB может считывать только нужные столбцы и обрабатывать их без предварительного импорта в базу.
Преимущества DuckDB для аналитики
У DuckDB есть важные преимущества по сравнению с серверными СУБД и табличными редакторами:
- Работает локально. Инструмент запускается непосредственно на компьютере, поэтому для анализа данных не нужно настраивать серверную базу.
- Работает непосредственно с файлами. CSV и Parquet можно использовать как источники данных без предварительного импорта.
- Поддерживает SQL. Для работы с данными можно использовать знакомые команды и агрегатные функции.
- Подходит для быстрых исследований. Не нужно строить полноценную инфраструктуру, если нужно проверить идею или разобраться в новом наборе данных.
- Работает с большими наборами данных. DuckDB рассчитан на аналитические задачи и позволяет выполнять запросы к объемным датасетам.
При этом DuckDB не стоит рассматривать как универсальную замену серверным СУБД. Если база должна постоянно обслуживать приложение или с данными одновременно работают много пользователей, лучше использовать специализированные системы, например, PostgreSQL.
Главное о DuckDB
- DuckDB — это аналитическая СУБД для локального анализа и быстрых исследований.
- Программа выполняет SQL-запросы непосредственно над файлами, не создавая отдельную базу данных.
- DuckDB поддерживает файлы форматов CSV и Parquet, их можно использовать как источники и обрабатывать привычными SQL-запросами.
- С помощью DuckDB можно фильтровать, сортировать и объединять данные из одного или нескольких файлов.
- Для приложений и многопользовательской работы лучше выбрать серверную СУБД.
FAQ
Что такое DuckDB простыми словами?
DuckDB — аналитическая СУБД, которую можно запускать на компьютере. Она выполняет SQL-запросы над данными и работает с файлами типа CSV и Parquet без отдельного сервера.
Можно ли открыть CSV в DuckDB без загрузки в базу?
Да, DuckDB умеет обращаться к CSV непосредственно в SQL-запросе. Необязательно импортировать файл и создавать для него отдельную таблицу.
Чем DuckDB отличается от PostgreSQL?
DuckDB и PostgreSQL решают разные задачи. DuckDB ориентирован на аналитические запросы и удобен для локальной работы с данными, а PostgreSQL — серверная СУБД, которую часто используют для приложений и многопользовательских систем.
Что лучше для аналитики — CSV или Parquet?
Оба формата можно использовать для анализа. CSV проще читать и передавать между программами, а Parquet эффективнее работает с большими объемами.
Подходит ли DuckDB для больших объемов данных?
DuckDB рассчитан на аналитическую обработку и может работать с большими наборами данных. Это удобный вариант для локального запуска, но для многопользовательской системы лучше выбрать серверную СУБД.