

Форматирование строк в Python позволяет удобно работать с текстом: подставлять значения переменных, управлять отображением данных и создавать аккуратные таблицы. В этой статье разберем основные способы форматирования — от классического оператора % до современных f-строк, научимся применять их на практике и выясним, в каких случаях достаточно конкатенации. В конце закрепим знания на небольшой задаче по созданию таблицы.
Немного о строках в Python и зачем нужно форматирование
В языке Python строки — это неизменяемые последовательности символов, заключенные в одинарные, двойные или даже тройные кавычки. Строки служат основным инструментом для работы с текстовой информацией. Поскольку текстовые данные окружают нас повсюду, умение гибко управлять ими является базовым навыком любого программиста. Каждый раз, когда мы объединяем цитаты, выводим сообщения пользователю или генерируем отчеты, мы опираемся на строковый тип данных.
Однако простого создания строк часто оказывается недостаточно. Текст в реальных программах динамичен: в него постоянно нужно подставлять новые значения, будь то числа, имена или даты. Поскольку строка — неизменяемый объект, любой метод, казалось бы «изменяющий» ее, на самом деле возвращает новую строку. Это же касается и форматирования: результатом всегда становится новый объект. Простое склеивание строк (конкатенация), конечно, работает, но при множественном применении создает промежуточные копии, что малоэффективно.
Для решения этой проблемы в Python существует несколько способов форматирования строк. Они позволяют создавать сложные текстовые конструкции из отдельных фрагментов путем подстановки необходимых значений в строковые шаблоны, сохраняя код читаемым и элегантным. Далее рассмотрим эти способы от самых старых к самым современным.
Устаревший способ: оператор %
Исторически первым способом подстановки значений в строки был оператор %, унаследованный Python из языка C, в частности, из функции printf. Этот метод сейчас считается устаревшим, однако его все еще можно встретить в старых библиотеках или легаси-коде. Принцип работы довольно прост: внутри строки расставляются специальные спецификаторы (плейсхолдеры), например, %s для строк, %d для целых чисел, а после строки через оператор % передается кортеж со значениями. Пример:
quote = "Береги %s снову, а %s %s." % ("платье", "честь", "смолоду")

print(quote)
В результате получим следующий вывод:
Береги платье снову, а честь смолоду.
Как видим, все 3 слова из кортежа заняли свои места в строке. Пример с разными типами плейсхолдеров:
book = "Война и мир"
volume = 1
weight = 0.44
pages = 448

print("«%s», том %d, вес: %.2f кг, %d страниц." % (book, volume, weight, pages))
В консоли получим:
«Война и мир», том 1, вес: 0.44 кг, 448 страниц.
Также этот способ поддерживает именованные подстановки через словарь:
person = "Петр Первый"
city = "Санкт-Петербург"
year = 1703

print("%(person)s основал %(city)s в %(year)d году." % {"person": person, "city": city, "year": year})
Здесь мы вместо кортежа используем словарь, который состоит из пар ключ – значение. Такой способ более наглядный: сразу видно, где и какое значение в строке должно находиться. Получим следующий результат:
Петр Первый основал Санкт-Петербург в 1703 году.
Метод str.format()
Это уже более современный метод, который появился с приходом Python 3. Этот метод позднее даже перенесли (бэкпортировали) из Python 3 в более раннюю версию Python 2.6. Данный способ форматирования долгое время оставался основным и рекомендуемым для использования. Здесь плейсхолдеры обозначаются фигурными скобками, а аргументы передаются в вызове метода:
novel = "Преступление и наказание"
city = "Петербург"

print("Город {} — это не просто фон для романа «{}».".format(city, novel))
Получим такой вывод:
Город Петербург — это не просто фон для романа «Преступление и наказание».
Также можно использовать позиционные подстановки, обозначая индексами нужный аргумент:
template = ("{0} так ждут {1}, будто он — волшебная кнопка: нажал — и все сразу стало лучше. "
            "{1} дарит надежду, что впереди только хорошее.")

print(template.format("Люди", "Новый год"))
Вывод в консоли:
Люди так ждут Новый год, будто он — волшебная кнопка: нажал — и все сразу стало лучше. Новый год дарит надежду, что впереди только хорошее.
Еще есть возможность передавать аргументы по именам, что исключает путаницу с порядком их следования в шаблоне:
print("{author}, «{title}» ({year})".format(
    author="А. П. Чехов",
    title="Палата № 6",
    year=1892
))
Получим такую строку:
А. П. Чехов, «Палата № 6» (1892)
Данный метод также умеет работать с числами. Вот так, например, можно легко округлить число с точностью до четырех знаков после запятой:
pi = 3.14159265358979

print("Число Пи: {:.4f}".format(pi))
Результат:
Число Пи: 3.1416
Или вот пример вычисления отношения 1 к 6, выраженного в процентах:
ratio = 1 / 6

print("Отношение: {:.2%}".format(ratio))
Получим:
Отношение: 16.67%
Шаблоны string.Template
Шаблоны из класса Template — это упрощенный механизм, в котором плейсхолдеры обозначаются знаком доллара. Этот механизм не поддерживает сложное форматирование чисел и некоторые другие возможности, зато безопасен и предсказуем, что делает его удобным для работы с пользовательскими шаблонами:
from string import Template

template = Template("«$novel», автор: $author, год: $year")

result = template.substitute(
    novel="Мертвые души",
    author="Н. В. Гоголь",
    year=1842
)

print(result)
Метод substitute подставляет в шаблон template нужные значения вместо плейсхолдеров и составляет таким образом строку, которую затем и возвращает. В результате получим следующий вывод:
«Мертвые души», автор: Н. В. Гоголь, год: 1842
Если какой-то ключ будет отсутствовать, то метод выкинет исключение KeyError. Чтобы исключений не было, следует вместо substitute использовать метод safe_substitute:
from string import Template

template = Template("Герой: $hero, друг: $friend")

print(template.safe_substitute(hero="Обломов"))
Результат:
Герой: Обломов, друг: $friend
Как видим, вместо значения получили сам плейсхолдер.
Самый современный способ: f-строки
Начиная с Python 3.6, разработчики получили в свое распоряжение f-строки. На сегодняшний день это самый современный, быстрый и рекомендуемый способ форматирования строк. Чтобы превратить обычную строку в f-строку, перед открывающей кавычкой достаточно поставить букву f или F.
Главное преимущество этого способа заключается в том, что внутрь фигурных скобок можно вставлять не просто имена переменных, а любые валидные выражения Python — вызовы функций, математические операции или методы объектов. Они вычисляются прямо «на лету». Сначала посмотрим на самое простейшее применение f-строк:
hero = "Обломов"
action = "лежать на диване"

print(f"{hero} очень любил {action}.")
Результат:
Обломов очень любил лежать на диване.
А вот пример с вычислением длины строки прямо внутри фигурных скобок:
quote = "Счастливые часов не наблюдают."

print(f"Длина цитаты: {len(quote)} символов.")
Получим такой вывод:
Длина цитаты: 30 символов.
Или вот так можно узнать первое слово приведенной строки:
name = "Анна Каренина"

print(f"Первое слово: {name.split()[0]}.")
В консоли будет следующий результат:
Первое слово: Анна.
Все возможности форматирования чисел, доступные в str.format(), работают и в f-строках:
parts = 25
total = 1500
fraction = parts / total

print(f"{parts} от {total} — это {fraction:.2%}.")
Получим:
25 от 1500 — это 1.67%.
Также при помощи тройных кавычек можно использовать многострочные f-строки:
author = "Ф. М. Достоевский"
title = "Преступление и наказание"
year = 1866

book_info = f"""
Книга: «{title}»
Автор: {author}
Год издания: {year}
"""

print(book_info)
Результат:
Книга: «Преступление и наказание»
Автор: Ф. М. Достоевский
Год издания: 1866
Начиная с версии Python 3.8 появилась возможность применять в f-строках упрощенный отладочный синтаксис. Раньше, чтобы получить имя и значение переменной в консоли, приходилось прописывать имя переменной прямо в строке:
novel = "Война и мир"
volumes = 4

print(f"Роман novel={novel} состоит из volumes={volumes}
Теперь достаточно просто добавить знак «равно» после переменной в фигурных скобках:
novel = "Война и мир"
volumes = 4

print(f"Роман {novel=} состоит из {volumes=} томов")
Получим:
Роман novel='Война и мир' состоит из volumes=4 томов
Создание таблиц
Чтобы текст не «ехал» при выводе списков или таблиц, можно задать фиксированную ширину столбца и направление выравнивания. Для этого используются следующие символы:
- < — выравнивание по левому краю.
- > — выравнивание по правому краю.
- ^ — выравнивание по центру.
Вот простой пример, как при помощи метода str.format и символа выравнивания < создать самую простую табличку:
heroes_characters = [("Вронский", "чувства"), ("Каренин", "разум"), ("Левин", "поиск")]

for hero, character in heroes_characters:
    print("{:<10} | {}".format(hero, character))
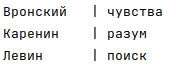
Здесь мы имеем список кортежей, по которому пробегается цикл for. С каждой итерацией мы получаем новую строку, в которой для первого слова применяется выравнивание по левому краю. Вывод в консоли:
Ну и, конечно, с помощью f-строк тоже можно создавать таблицы:
heroes_descriptions = [
    ("Манилов", "Приторно-сладкий"),
    ("Коробочка", "Бережливая старуха"),
    ("Ноздрев", "Удалой говорун"),
    ("Плюшкин", "Прореха на человечестве")
]

print(f"{'Герой':^15} | {'Описание':^20}")
print("-" * 41)

for hero, description in heroes_descriptions:
    print(f"{hero:<15} | {description:<20}")
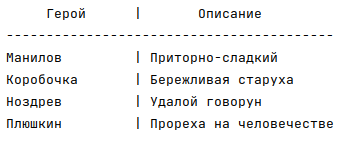
Здесь, в принципе, все то же самое, что и в предыдущем примере, только добавилась шапка таблицы с разделителем в виде горизонтальной пунктирной линии. Для слов в шапке таблицы применяется выравнивание по центру, а для содержимого таблицы — по левому краю. В консоли увидим следующее:
Еще примеры с f-строками
Если перед символом выравнивания (<, >, ^) поставить любой знак, то Python заполнит им все пустые места в строке вместо обычных пробелов. Это идеально подходит для создания красивых заголовков, меню, бланков и других полезных вещей. Пример:
# Оформляем название повести Пушкина
title = "МЕТЕЛЬ"

# Центрируем текст в полосе из 30 символов, заполняя пустоты знаками равенства
formatted_title = f"{title:=^30}"
print(formatted_title)

# Сделаем красивую строку для содержания книги (заполнение точками)
chapter_name = "Глава I"
page_number = 3
print(f"{chapter_name:.<25}{page_number:>5}")
Результат:
Или вот пример кода простенькой рамки с текстом по центру:
text = "ПРИВЕТ!!!"
frame_width = len(text) + 4  # по 2 пробела с каждой стороны

top_bottom = f"+{'-' * frame_width}+"
middle = f"|  {text}  |"

print(top_bottom)
print(middle)
print(top_bottom)
Здесь не используются символы выравнивания, а ширина рамки зависит от длины текста. Вот так эта рамка выглядит:
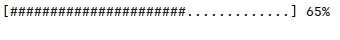
В некоторых консольных приложениях используются прогресс-бары. Ниже представлен пример такого прогресс-бара:
current = 65
bar_length = 35

filled = int(bar_length * current / 100)
empty = bar_length - filled

bar = f"[{'#' * filled}{'.' * empty}] {current}%"
print(bar)
Сначала задаем значение процентов, которое нужно отобразить, и длину прогресс-бара. Потом с помощью простых формул определяем заполненную и пустую области. Далее на основании вычисленных значений конструируем прогресс-бар при помощи f-строки. Получим следующее:
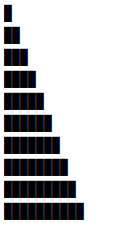
Следующий пример строит лестницу из 10-и ступеней, выровненную по левому краю:
steps = 10
step_char = "█"

for i in range(1, steps + 1):
    # i символов, выровнены влево в поле ширины steps
    print(f"{step_char * i:<{steps}}")
Вот такая лесенка будет выведена в консоли:
Если изменить символ выравнивания на противоположный в последней строке, то лестница развернется наоборот:
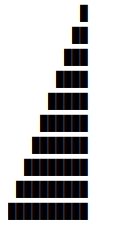
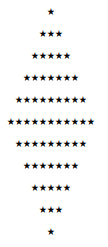
Ну и напоследок построим ромб:
height = 11
char = "★"

# Верхняя половина (включая центр)
for i in range(1, height + 1, 2):
    print(f"{char * i:^{height}}")

# Нижняя половина
for i in range(height - 2, 0, -2):
    print(f"{char * i:^{height}}")
Здесь у нас аж 2 цикла for: один строит верхнюю половину с центральной областью, а другой — нижнюю. В каждом цикле применяется выравнивание по центру. Получим такой результат:
Когда обычная конкатенация уместна, а когда — нет
Как уже говорилось в начале этой статьи, конкатенация малоэффективна при множественном применении, так как при этом создается много промежуточных копий. Но все же ее никто не запрещает применять и в некоторых ситуациях она вполне оправдана. Однако область ее применения в современном Python сильно сузилась из-за появления f-строк. Вот всего лишь пара сценариев, когда конкатенация уместна:
Склеивание нескольких простых строк. Если надо соединить несколько текстовых переменных без их дальнейшего изменения, то конкатенация здесь вполне уместна:
first_name = "Иван"
middle_name = "Федорович"
last_name = "Тютчев"

full_name = first_name + " " + middle_name + " " + last_name  # Просто и понятно
Динамическое накопление текста в цикле. Когда на каждом шаге цикла добавляется очередной фрагмент к строке:
text = "Пора "

for word in ["в", " путь-", "дорогу."]:
    text += word
Но это хорошо работает, если элементов немного. В противном случае лучше использовать метод join:
words_list = []

for word in ["в", " путь-", "дорогу."]:
    words_list.append(word)

text = "Пора " + "".join(words_list)
Или можно еще короче, без цикла:
text = "Пора " + "".join(["в", " путь-", "дорогу."])
А вот случаи, когда от конкатенации лучше отказаться:
- Когда много переменных в сложных шаблонах, в том числе в многострочных.
- При использовании чисел, дат, процентов, валюты, так как в этих случаях конкатенация требует ручного приведения типов.
- При округлении чисел, так как не нужно вызывать, например, тот же метод round.
- Если надо что-то выравнивать, создать таблицу и тому подобное.
Далее предлагаем выполнить небольшое задание.
Задание для самостоятельного выполнения
Имеется 3 словаря с данными о книгах из русской классики:
{"title": "Война и мир", "author": "Л. Н. Толстой", "pages": 1456, "read": 890}

{"title": "Преступление и наказание", "author": "Ф. М. Достоевский", "pages": 672, "read": 672}

{"title": "Мертвые души", "author": "Н. В. Гоголь", "pages": 352, "read": 75}
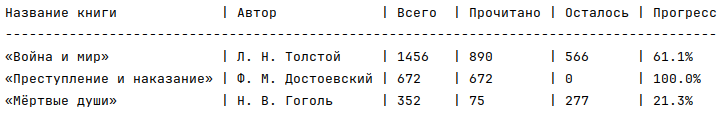
Требуется вывести информацию для каждой книги в виде таблицы, состоящей из колонок со следующими данными:
- название книги;
- автор;
- всего страниц;
- сколько страниц прочитано;
- сколько осталось прочитать;
- процент прочитанного, округленный до одного знака после запятой.
Решение:
Объединяем все 3 словаря в один список и присваиваем ему имя books. Далее создаем шапку таблицы с указанными разделами и отделяем ее от основной части пунктиром. Потом запускаем цикл for, который проходит по всем трем словарям, извлекает из них необходимые данные, вычисляет значения для количества оставшихся страниц и процента прочитанного и конструирует из всего этого таблицу. Получим следующий код:
books = [
    {"title": "Война и мир", "author": "Л. Н. Толстой", "pages": 1456, "read": 890},
    {"title": "Преступление и наказание", "author": "Ф. М. Достоевский", "pages": 672, "read": 672},
    {"title": "Мертвые души", "author": "Н. В. Гоголь", "pages": 352, "read": 75},
]

print(f"{'Название книги':<26} | {'Автор':<17} | {'Всего':<6} | {'Прочитано':<9} | {'Осталось':<8} | {'Прогресс'}")
print("-" * 89)

for book in books:
    title = book["title"]
    author = book["author"]
    pages = book["pages"]
    read = book["read"]

    left = pages - read
    percent = read / pages * 100

    print(f"{f'«{title}»':<26} | {author:<17} | {pages:<6} | {read:<9} | {left:<8} | {percent:.1f}%")
Результат: