

Как специалист, который провел не одну бессонную ночь над датасетами на Kaggle и внедрил десятки моделей в продакшен, я могу сказать одну важную вещь: все сложное машинное обучение строится на фундаменте базовой статистики. Сегодня мы разберем три главных кита, на которых держится анализ данных — среднее, медиану и моду.
Казалось бы, это школьная программа и что тут обсуждать. Но поверьте моему опыту: из-за непонимания разницы между этими тремя метриками рушатся бизнес-отчеты, неверно интерпретируются результаты A/B-тестов, а ML-модели выдают абсурдные прогнозы. В этой статье я максимально простым языком, на жизненных примерах, покажу вам, как работают среднее, медиана и мода, чем они отличаются и когда какую из них нужно использовать.
Что такое меры центральной тенденции и зачем они нужны
Представьте, что вы устроились аналитиком данных в крупный интернет-магазин. В ваш первый рабочий день начальник присылает вам таблицу с историей покупок за год. В ней 10 миллионов строк. Каждая строка — это сумма чека конкретного клиента.
Начальник спрашивает: «Ну как там наши продажи? Сколько в среднем тратит наш клиент?»
Вы не можете распечатать 10 миллионов строк и принести ему на стол. Вы не можете прочитать их вслух. Человеческий мозг не способен воспринять такой объем сырой информации. Нам нужен способ сжать эти 10 миллионов чисел до одного-единственного числа, которое будет описывать всю эту огромную массу данных.
Именно этим и занимается описательная статистика (Descriptive Statistics). Она берет хаос сырых данных и превращает его в понятные метрики.
Метрики, которые пытаются найти центр, типичного представителя или самое ожидаемое значение в наборе данных, называются мерами центральной тенденции. Это попытка ответить на вопрос: «Если бы мне пришлось описать все эти данные одним числом, какое число я бы выбрал?»
Для этого у нас есть три главных инструмента — среднее арифметическое, медиана и мода. Давайте разберем каждый из них.
Среднее арифметическое (Mean)
Среднее арифметическое (часто его называют просто средним) — это сумма всех значений в наборе данных, разделенная на количество этих значений. Это самая популярная и интуитивно понятная мера.
Формула: если у нас есть набор данных
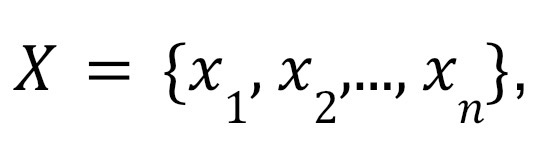
то среднее считается так:
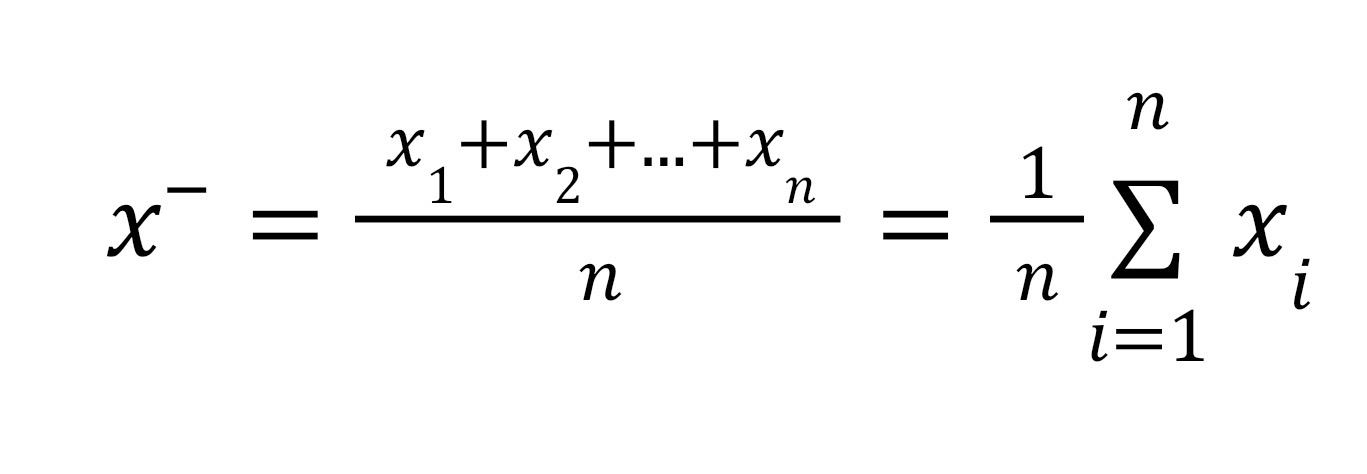
Ключевые свойства среднего:
- Участие каждого элемента. В расчете среднего участвует абсолютно каждое число из вашего датасета. Измените хотя бы одно значение на сотую долю — и среднее тоже изменится.
- Сумма отклонений равна нулю. Если вы возьмете каждое число в датасете, вычтете из него среднее, а потом сложите все эти разницы, вы получите ровно ноль. Среднее — это физический центр масс (как точка равновесия на качелях).
Главная слабость: чувствительность к выбросам (Outliers)
У того факта, что каждое число влияет на среднее, есть темная сторона. Среднее катастрофически боится аномалий.
Пример из жизни. Представьте бар, в котором сидят девять обычных работяг. Зарплата каждого из них — около 100 000 рублей в месяц. Средняя зарплата в баре:
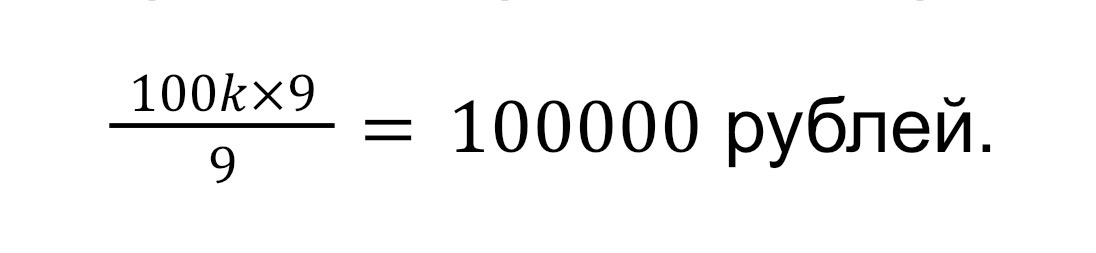
Пока все логично.
Вдруг дверь открывается, и в бар заходит Илон Маск. Допустим, его доход составляет 1 миллиард рублей в месяц. Считаем новое среднее:
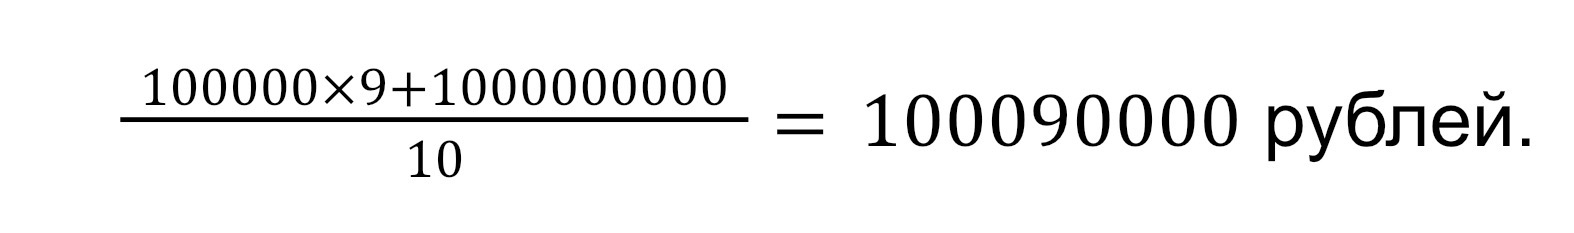
Поздравляю! В среднем каждый человек в этом баре теперь долларовый миллионер. Но стали ли работяги богаче? Нет. Описывает ли цифра «100 миллионов» реальную статистику по доходам людей в этом помещении? Абсолютно нет. Илон Маск выступил в роли выброса (outlier) — экстремально большого значения, которое перетянуло среднее на себя.
Другие виды средних (кратко)
В машинном обучении вы встретите не только арифметическое среднее:
- Взвешенное среднее. Каждому числу дается свой «вес» (важность). Например, итоговая оценка в университете: дипломная работа весит больше, чем рядовой реферат.
- Геометрическое среднее. Используется, когда мы работаем с темпами роста (например, рост инвестиционного портфеля в процентах из года в год).
- Гармоническое среднее. Подходит, например, для вычисления средней скорости на равных участках пути. ML-факт: знаменитая метрика качества моделей классификации F1-score — это именно гармоническое среднее между Precision (точностью) и Recall (полнотой)! Оно штрафует модель, если хотя бы одна из этих метрик близка к нулю.
Медиана (Median)
Медиана — это значение, которое делит упорядоченный (отсортированный по возрастанию или убыванию) набор данных ровно пополам. Если среднее — это математический центр масс, то медиана — это физическая середина отсортированного списка.
Порядок расчета:
- Сначала мы обязательно сортируем данные.
- Если количество наблюдений нечетное, медиана — это число ровно посередине. Пример: {2, 4, 5, 7, 9}. Медиана = 5.
- Если количество наблюдений четное, то точной середины нет. Тогда мы берем два числа посередине и находим их среднее арифметическое. Пример: {2, 4, 5, 7, 9, 10}. Медиана = (5 + 7) / 2 = 6.
Суперсила медианы: устойчивость к выбросам (Robustness)
Давайте вернемся в наш бар с работягами и Илоном Маском. Зарплаты 10 человек по возрастанию: 100k, 100k, 100k, 100k, 100k, 100k, 100k, 100k, 100k, 1 000 000 000.
Количество четное (10). Берем два центральных значения (пятое и шестое). Оба они равны 100 000. Медиана = (100k + 100k) / 2 = 100 000 рублей.
Идеально! Медиана проигнорировала миллиард Маска и показала нам реальную картину — «типичный» доход человека в баре. В ML мы называем такие метрики робастными — то есть устойчивыми к шуму и аномалиям.
Связь с квантилями и перцентилями
В анализе данных вы часто будете слышать слово «перцентиль» (percentile). Перцентиль показывает, какой процент данных лежит ниже определенного значения. Медиана — это 50-й перцентиль (или p50). Ровно 50% данных меньше нее. Если говорят, что ваша зарплата находится на 90-м перцентиле (p90), это повод для гордости: вы зарабатываете больше, чем 90% людей в выборке.
Мода (Mode)
Мода — это значение, которое встречается в наборе данных чаще всего, самый популярный элемент.
Расчет для разных типов данных:
- Дискретные данные (целые числа, категории). Пример: {1, 2, 2, 2, 3, 4}. Мода = 2 (встречается трижды).
- Непрерывные данные (числа с плавающей точкой). Если у вас данные вроде роста людей с точностью до миллиметра (175.43 см, 180.12 см), то каждое значение может встретиться ровно один раз. Мода в таком случае не имеет смысла. Чтобы найти моду для непрерывных данных, их разбивают на «корзины» (bins) — строят гистограмму, и модой считается тот диапазон (интервал), в который попало больше всего значений.
Особенности моды
- Отсутствие единственной моды. Если все значения встречаются одинаковое количество раз (например, {1, 2, 3, 4}), единственной моды нет.
- Множественность моды. В отличие от среднего и медианы, которые всегда представлены одним числом, мод может быть несколько!
- Унимодальное распределение. Один четкий пик (одна мода).
- Бимодальное распределение. Два пика (две моды). Пример из жизни: если измерить рост всех посетителей торгового центра, вы, скорее всего, увидите два пика — средний рост женщин (около 165 см) и средний рост мужчин (около 178 см).
- Мультимодальное. Три и более пиков.
Суперсила моды: категориальные данные
Среднее работает с количественными данными, а медиана — с количественными и упорядоченными данными. Вы не можете посчитать среднее арифметическое между словами «Красный», «Синий» и «Зеленый». Вы не можете их отсортировать, чтобы найти медиану (алфавитный порядок не имеет математического смысла). А вот моду — можно! Если вы продали 10 красных машин, 5 синих и 2 зеленых, то ваша мода — «Красный». Для текстовых (категориальных) признаков в ML мода — это стандартный способ найти наиболее частое значение.
Чем отличаются медиана, мода и среднее
Давайте структурируем разницу между метриками. Это база, которую часто спрашивают на собеседованиях на позицию Junior Data Scientist.
| Характеристика | Среднее (Mean) | Медиана (Median) | Мода (Mode) |
| Тип данных | Только количественные (числа) | Количественные и порядковые | Любые (числа, категории, текст) |
| Чувствительность к выбросам | Очень высокая (сильно искажается) | Низкая (робастна) | Низкая |
| Вычислительная сложность | O(n) — быстро (просто сложить все) | O(nlogn) — медленнее (нужна сортировка)* | O(n) с использованием хэш-таблиц |
| Гарантия существования | Всегда существует | Мод может быть несколько | Может не быть, может быть несколько |
*Примечание для гиков: существуют алгоритмы поиска медианы в среднем за O(n), например Quickselect, но стандартная сортировка обычно работает за O(nlogn).
Когда использовать медиану, моду и среднее
Знать формулы — это 10% успеха Data Scientist-а. А 90% — это понимать бизнес-контекст. Давайте разберем, когда какую метрику применять.
Зарплаты, доходы населения, богатство
Используем медиану. Доходы часто имеют скошенное вправо распределение (positive skew). Бедных и среднего класса много, а миллиардеров мало, но их капиталы огромны. Если в новостях говорят: «Средняя зарплата в регионе составила 150 000 рублей», это еще не значит, что столько получает обычный человек. А вот «Медианная зарплата — 60 000 рублей» означает, что ровно половина населения получает меньше 60к, а половина — больше. Это честная метрика.
Цены на недвижимость
Используем медиану. Та же логика. Один проданный пентхаус за 2 миллиарда исказит среднюю стоимость квадратного метра в районе так, что он покажется элитным. В ML-задачах мы часто предсказываем логарифм цены, чтобы уменьшить влияние сильной асимметрии распределения.
Время ответа сервиса / сайта (Latency)
Используем медиану и перцентили (p50,p90,p99). Представьте, что вы ML-инженер и развернули нейросеть в виде API. Вы хотите знать, как быстро она отвечает пользователям. Среднее время ответа — плохая идея. Если 99 запросов обработались за 10 мс, а один завис на 10 секунд из-за сбоя сети, среднее будет испорчено. В IT принято смотреть на следующее:
- p50 (медиана) — значение задержки, в которое укладывается 50% запросов;
- p90 — значение задержки, в которое укладывается 90% запросов;
- p99 — значение задержки, в которое укладывается 99% запросов; если ваш p99 в норме, значит, почти все запросы укладываются в приемлемую задержку.
Результаты опросов и рейтинги
Используем моду или медиану. Если пользователи оценивают ваш товар звездочками от 1 до 5, средняя оценка 4,2 мало о чем говорит. А вот если мода = 5 (пятерка встречается чаще всего), но медиана = 4 (половина поставила 4 и ниже), это дает больше понимания.
A/B-тесты
Используем среднее (с оговорками). Несмотря на всю критику среднего, в классическом A/B-тестировании (например, при проверке, увеличилась ли конверсия или выручка с пользователя при смене дизайна) чаще всего используют именно среднее. Почему? Из-за магии Центральной Предельной Теоремы (ЦПТ). Она гласит, что распределение выборочных средних будет стремиться к нормальному, даже если сами данные скошены. Это позволяет применять мощные статистические тесты (t-test). Однако для сильно скошенных метрик (ARPU) продвинутые аналитики используют трансформации или непараметрические тесты, например тест Манна-Уитни для сравнения распределений двух независимых выборок.
Золотое правило аналитика: всегда считайте и смотрите на все три метрики! Если среднее сильно отличается от медианы, то это может указывать на выбросы или асимметрию распределения. Постройте гистограмму и посмотрите на распределение глазами.
Считаем метрики на практике (Python)
Мы будем использовать стандартную библиотеку statistics, мощный вычислительный движок NumPy и любимый инструмент всех дата-сайентистов Pandas.
Представим, что мы собрали данные о возрасте 11 посетителей IT-конференции.
import numpy as np
import pandas as pd
import statistics
import matplotlib.pyplot as plt
import seaborn as sns

# Данные: возраст посетителей.
# Обратите внимание на 85 - это явно выброс (случайно зашел дедушка)
ages = [22, 24, 24, 25, 26, 28, 29, 31, 32, 35, 85]

# ==========================================
# 1. Использование встроенного модуля statistics
# ==========================================
print("--- Модуль statistics ---")
print(f"Среднее: {statistics.mean(ages):.1f}")
print(f"Медиана: {statistics.median(ages)}")
print(f"Мода: {statistics.mode(ages)}")

# ==========================================
# 2. Использование NumPy (стандарт для ML)
# ==========================================
print("\n--- Модуль NumPy ---")
# В numpy нет функции mode, здесь моду считаем через statistics и pandas
print(f"Среднее: {np.mean(ages):.1f}")
print(f"Медиана: {np.median(ages)}")
print(f"90-й перцентиль (p90): {np.percentile(ages, 90)}")

# ==========================================
# 3. Использование Pandas (работа с таблицами)
# ==========================================
print("\n--- Модуль Pandas ---")
df = pd.DataFrame({'Age': ages})

# Метод describe() сразу выдает кучу полезной статистики!
print("Описательная статистика:")
print(df['Age'].describe())

print(f"\nМода через Pandas:\n{df['Age'].mode().values}")

# ==========================================
# 4. Визуализация (чтобы увидеть все глазами)
# ==========================================
plt.figure(figsize=(10, 6))
sns.histplot(df['Age'], bins=15, kde=True, color='skyblue')

# Добавляем вертикальные линии для наших метрик
plt.axvline(np.mean(ages), color='red', linestyle='dashed', linewidth=2, label=f'Среднее ({np.mean(ages):.1f})')
plt.axvline(np.median(ages), color='green', linestyle='dashed', linewidth=2, label=f'Медиана ({np.median(ages)})')
plt.axvline(statistics.mode(ages), color='purple', linestyle='dashed', linewidth=2, label=f'Мода ({statistics.mode(ages)})')

plt.title('Распределение возраста посетителей конференции')
plt.xlabel('Возраст')
plt.ylabel('Частота')
plt.legend()
plt.show()
Разбор результатов: если вы запустите этот код, вы увидите, что мода = 24 (самый частый возраст), медиана = 28 (ровно половина людей младше 28, половина старше). А вот среднее = 32.8! Дедушка (85 лет) «состарил» нашу аудиторию в среднем почти на пять лет. Если вы скажете спонсорам, что средний возраст аудитории — 33 года, они привезут рекламу ипотеки. А на самом деле там сидит молодежь (медиана 28), которой интересны курсы по Python и гаджеты. Вот цена ошибки в выборе метрики!
Типичные ошибки новичков
Как человек, который провел сотни собеседований, я часто вижу одни и те же ошибки. Давайте разберем их, чтобы вы на них не попадались.
Ошибка 1: «Средняя температура по больнице»
Это классический мем в аналитике. Половина пациентов — в горячке (40°C), половина — в морге (20°C). Средняя температура — 30°C. Все здоровы! Мораль: никогда не используйте среднее для сильно бимодальных (двухгорбых) распределений. Если у вас две разные группы в данных, то их нужно сначала разделить (кластеризовать) и считать метрики для каждой группы отдельно.
Ошибка 2: считать среднее для категорий, закодированных числами
Иногда новички в ML кодируют категории числами: «Мужчина» = 1, «Женщина» = 2. А потом алгоритм или сам аналитик считает среднее и получает 1.5. Что такое 1.5 пола? Это бессмыслица. То же самое с почтовыми индексами. Средний почтовый индекс не имеет физического смысла. Для таких номинальных категорий используйте моду.
Ошибка 3: игнорирование парадокса Симпсона
Это коварное статистическое явление, когда тренд, видимый в разных группах данных, исчезает или меняется на противоположный, если эти группы объединить.
Пример на пальцах. Мы тестируем два лекарства (А и Б) от болезни:
- лекарство А дали 100 пациентам с легкой формой (выжило 90%) и 10 пациентам с тяжелой (выжило 10%);
- лекарство Б дали 10 пациентам с легкой формой (выжило 100%) и 100 пациентам с тяжелой (выжило 20%).
Если посчитать общее среднее (общую выживаемость), то выйдет следующее:
- лекарство А — (90 + 1) / 110 = 82.7% выживаемости;
- лекарство Б — (10 + 20) / 110 = 27.2% выживаемости.
Кажется, что лекарство А в разы лучше.Но посмотрите внимательно на группы:
- при легкой форме — Б (100%) лучше, чем А (90%);
- при тяжелой форме — Б (20%) лучше, чем А (10%).
Лекарство Б лучше в обоих случаях! Но из-за дисбаланса размеров групп (А давали в основном легким пациентам, а Б — тяжелым), общее среднее нагло нам врет. Мораль: всегда дробите данные на логичные сегменты перед тем, как считать средние значения.
Медиана, мода и среднее: коротко о главном
Подведем итоги нашего погружения в мир центральных тенденций.
Машинное обучение — это не просто бездумный импорт XGBoost или PyTorch и вызов метода .fit(). Это глубокое понимание природы ваших данных. Модели учатся на тех паттернах, которые вы им скормите. Если вы заполните пропуски в данных (Missing values) средним значением там, где нужно было использовать медиану, ваша модель может выучит искаженную картину мира и выдаст плохой результат.
Краткая шпаргалка на каждый день:
- Нужно быстро оценить средний уровень показателя? Используйте среднее.
- Данные искажены выбросами (зарплаты, цены, время)? Ваш лучший друг — медиана.
- Работаете с категориями, текстами или хотите узнать самый популярный товар? Выбирайте моду.
Не верьте слепо одной цифре. Всегда стройте графики (гистограммы, boxplot), смотрите на разницу между средним и медианой, исследуйте аномалии. И тогда ваши данные расскажут вам свою настоящую историю, а не ту, которую навязывают выбросы.
Надеюсь, эта статья помогла вам разложить все по полочкам! Если у вас остались вопросы, вы не согласны с каким-то примером или хотите, чтобы я разобрал конкретный кейс из вашей практики, — пишите в комментарии.