

Когда приложение разрастается, изменения в одном модуле начинают затрагивать весь проект: обновление требует больше времени, а сбой одного компонента может повлиять на работу системы целиком. Микросервисная архитектура решает эту проблему за счет разделения приложения на независимые сервисы, каждый из которых отвечает за свою задачу.
В статье разберем, как устроен такой подход, чем микросервисы отличаются от монолита, какие у них преимущества и недостатки и когда их действительно стоит использовать.
Что такое микросервисная архитектура
Микросервисная архитектура (MSA, Microservices Architecture) — это подход к построению приложения, при котором оно состоит из автономных сервисов, которые взаимодействуют между собой и с базой данных с помощью брокеров ообщений или API.
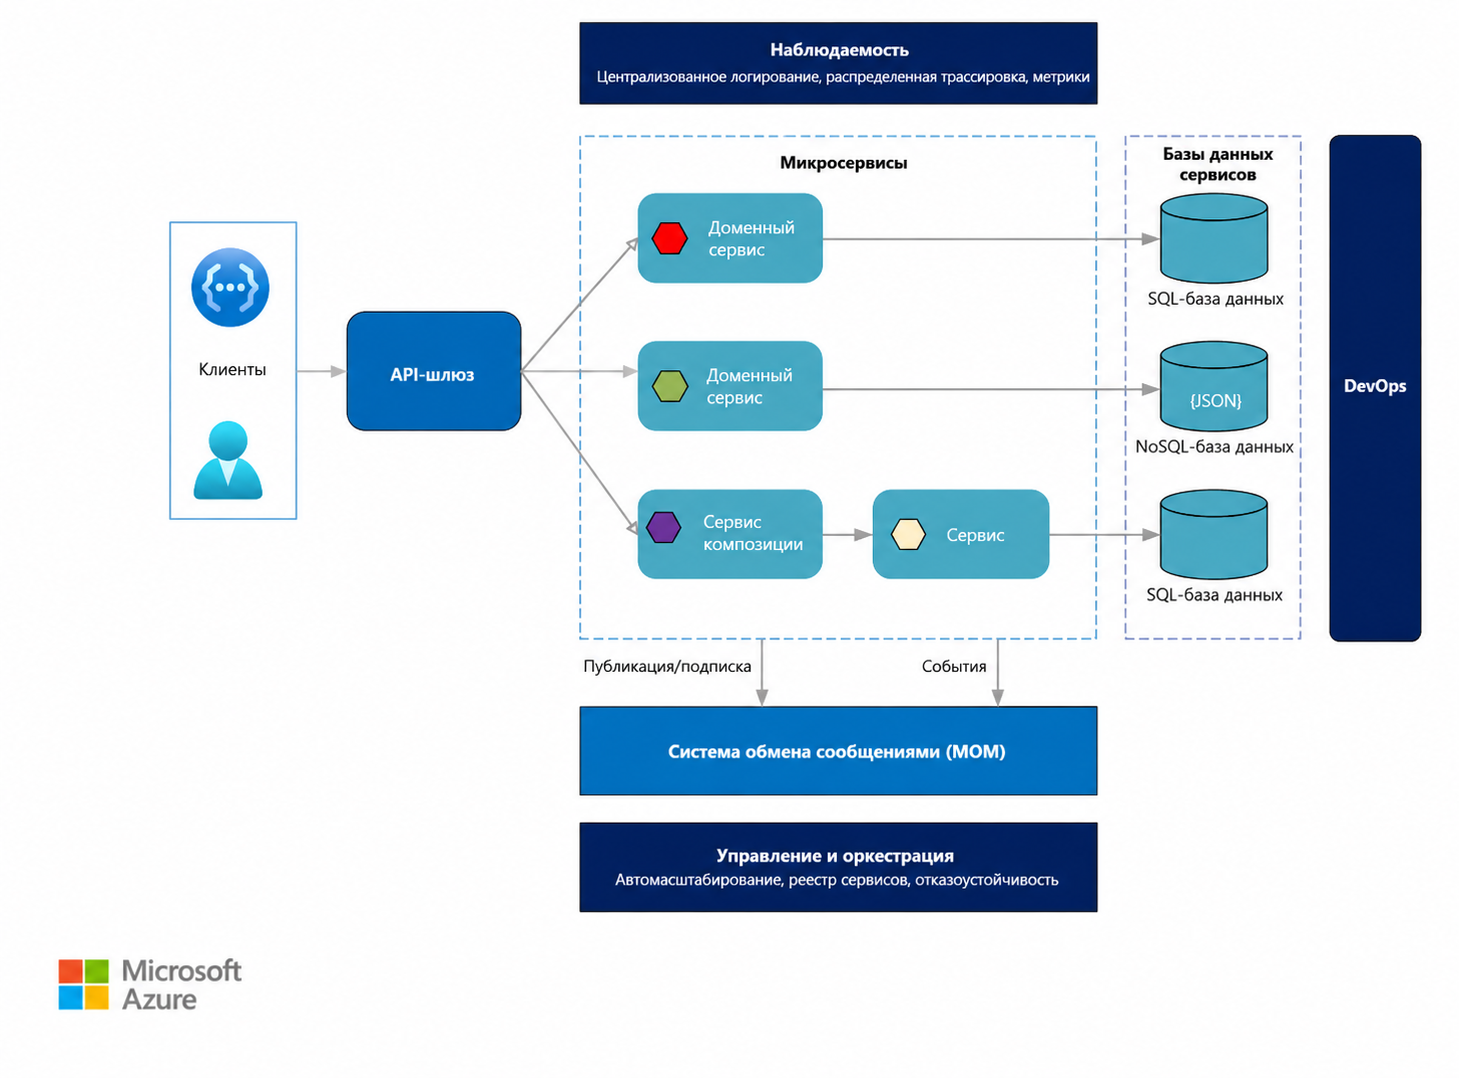
Чем микросервисная архитектура отличается от монолита
В отличие от монолита, в микросервисной архитектуре каждый компонент отвечает за конкретную бизнес-задачу, а разрабатывать, развертывать и масштабировать его можно отдельно от других.
Чтобы микросервисы работали правильно, нужно:
- определить их границы,
- решить, какими данными управляет каждый сервис,
- прописать, как они будут общаться друг с другом и что произойдет, если один из компонентов перестанет отвечать.
Основные принципы проектирования микросервисной архитектуры
Единого стандарта, который задавал бы обязательный набор принципов микросервисной архитектуры, нет.
Однако в профессиональной литературе выделяют несколько общих подходов к проектированию таких систем:
- Джеймс Льюис и Мартин Фаулер в своей статье о микросервисах описали основные черты этого архитектурного стиля: организацию сервисов вокруг бизнес-возможностей, децентрализованное управление данными, автоматизацию инфраструктуры и проектирование с учетом отказов.
- Сэм Ньюмен в Building Microservices («Создание микросервисов») рассматривает границы компонентов, их автономность, связанность и независимое развертывание.
- Крис Ричардсон в Microservices Patterns («Микросервисы. Паттерны разработки и рефакторинга») систематизирует архитектурные решения для декомпозиции системы, работы с данными, взаимодействия и отказоустойчивости.
Далее разберем основные принципы из этих источников и посмотрим, как они влияют на границы сервисов, данные, взаимодействие и отказоустойчивость системы.
Принцип 1. Разделение системы по бизнес-задачам
При проектировании микросервисов границы определяют не по технологическим слоям (интерфейс, бизнес-логика или работа с данными), а по тому, какую бизнес-задачу выполняет та или иная часть системы. При этом внутри одного микросервиса могут находиться и бизнес-логика, и средства работы с данными, и интерфейсы для взаимодействия с другими частями системы.
Джеймс Льюис и Мартин Фаулер называют этот подход Organized around Business Capabilities — «Организация в соответствии с бизнес-возможностями».
В референсном интернет-магазине Microsoft eShopOnContainers серверная функциональность разделена между несколькими микросервисами.
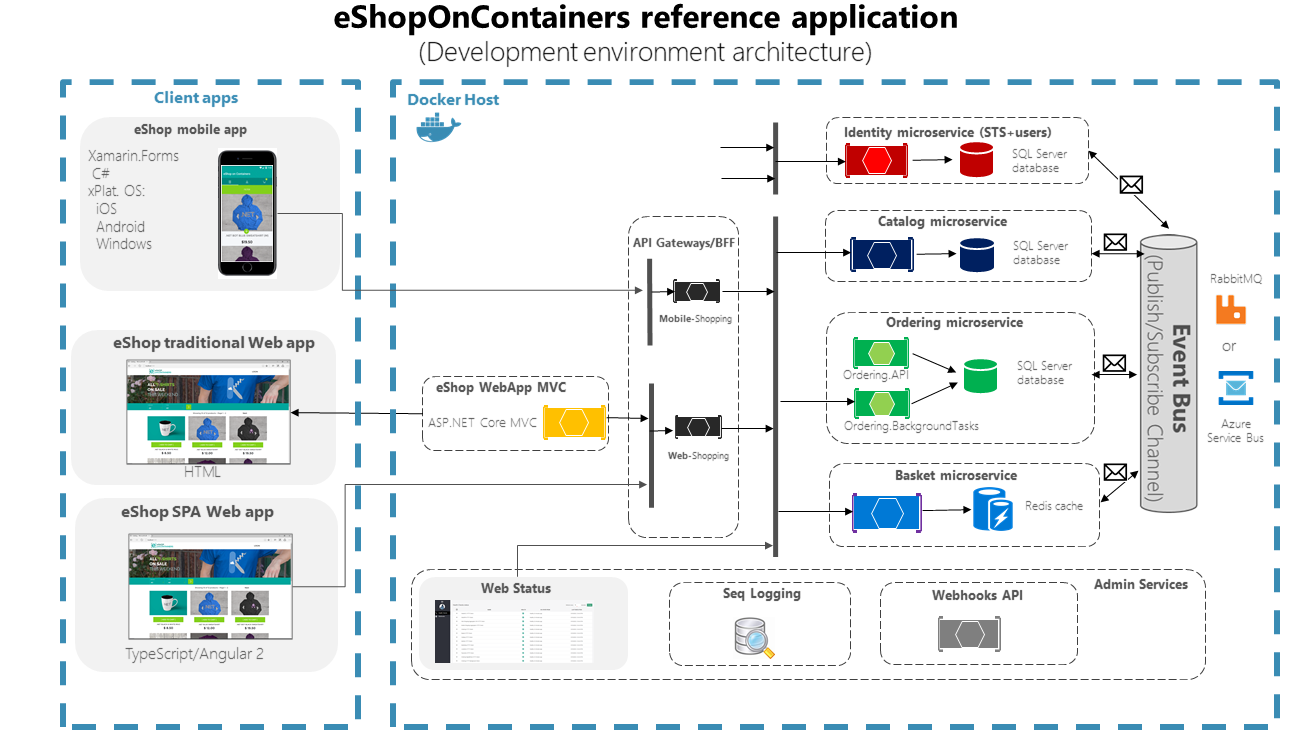
Identity отвечает за идентификацию пользователей.
Catalog — за каталог товаров.
Basket — за корзину.
Ordering — за работу с заказами.
Чтобы определить границы сервисов в более сложной системе, Azure Architecture Center рекомендуют использовать подход «Проектирование на основе домена» (DDD, Domain-driven design).
В DDD сначала изучают бизнес-домен — предметную область, для которой создается приложение. Например, для интернет-магазина таким доменом будет интернет-торговля.
Затем домен разделяют на ограниченные контексты (bounded contexts) — части, внутри каждой из которых действует своя модель предметной области. Например, понятие «товар» может описываться по-разному в каталоге и при оформлении заказа: каждому контексту нужны только те свойства и правила, которые относятся к его задаче.
Процесс выделения микросервисов выглядит так:
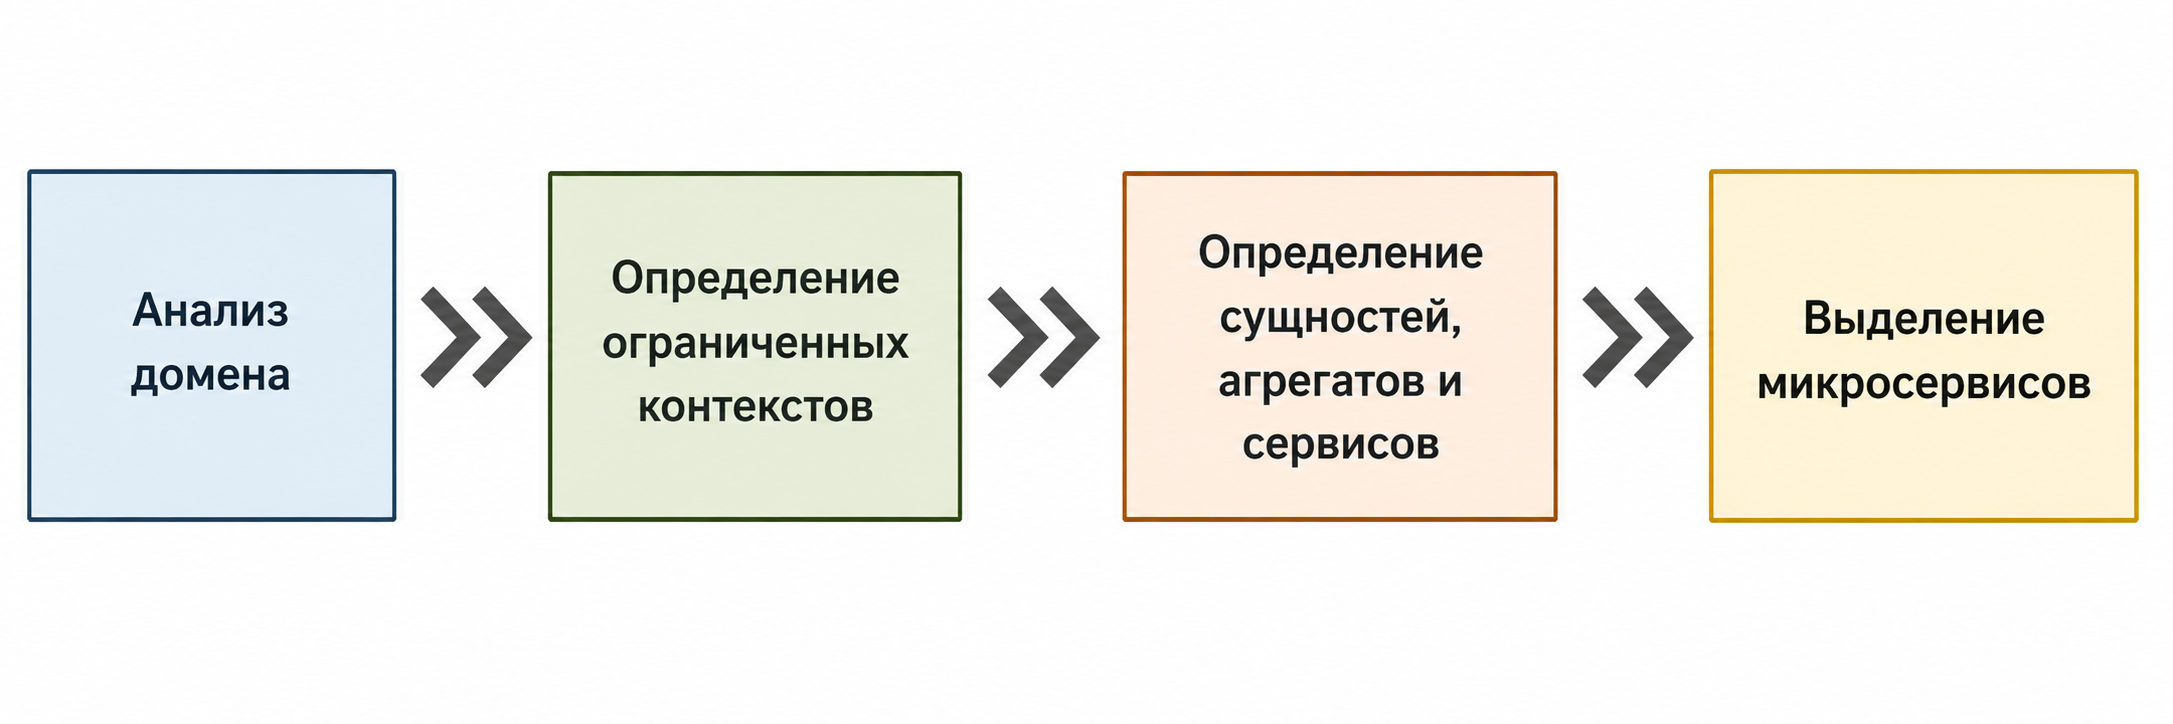
Внутри каждого ограниченного контекста разработчики уточняют модель и определяют, какие в ней нужны сущности, агрегаты и доменные сервисы.
- Сущность — объект, который важно отличать от других таких объектов и отслеживать во времени. Например, конкретный заказ остается тем же заказом, даже если его статус изменился.
- Агрегат — группа тесно связанных объектов, которыми управляют как единым целым. Например, заказ вместе с его позициями.
- Доменный сервис — компонент, в который выносят бизнес-логику, если ее нельзя логично отнести к ответственности конкретной сущности или агрегата. Например, расчет стоимости доставки может зависеть от заказа, адреса и выбранного способа доставки, поэтому такую операцию не обязательно помещать внутрь объекта Order.
Эти элементы помогают найти подходящие границы будущих микросервисов.
Граница микросервиса определяет, какая функциональность относится к конкретному сервису и за какую часть системы он отвечает. В Azure Architecture Center рекомендуют начинать ее поиск с ограниченного контекста.
Как правило, микросервис не должен быть меньше агрегата и не должен охватывать несколько ограниченных контекстов. То есть один агрегат обычно не разбивают между несколькими микросервисами, но внутри одного ограниченного контекста может находиться несколько микросервисов.
Агрегаты и доменные сервисы часто становятся кандидатами на такие микросервисы, но окончательные границы определяют с учетом устройства и требований конкретной системы.
Принцип 2. Автономность и слабая связанность сервисов
Важная особенность микросервисной архитектуры заключается в том, что сервисы можно изменять и развертывать независимо друг от друга.
Сэм Ньюман (автор книги «Создание микросервисов») считает, что независимое развертывание (independent deployability) — это одно из важнейших свойств микросервисов. Это свойство означает, что изменение одного сервиса по возможности не должно требовать одновременного изменения и развертывания остальных.
Поэтому каждый микросервис должен содержать бизнес-логику своей предметной области и не зависеть от большого количества обращений к другим сервисам для выполнения своих основных функций.
Автономность напрямую связана со слабой связанностью (loose coupling). Чем меньше сервису нужно знать о внутреннем устройстве других сервисов, тем проще изменять его независимо.
На практике независимое развертывание означает, что у микросервисов могут быть отдельные процессы сборки и выпуска. Если релиз одного сервиса не проходит, это не должно автоматически блокировать выпуск остальных.
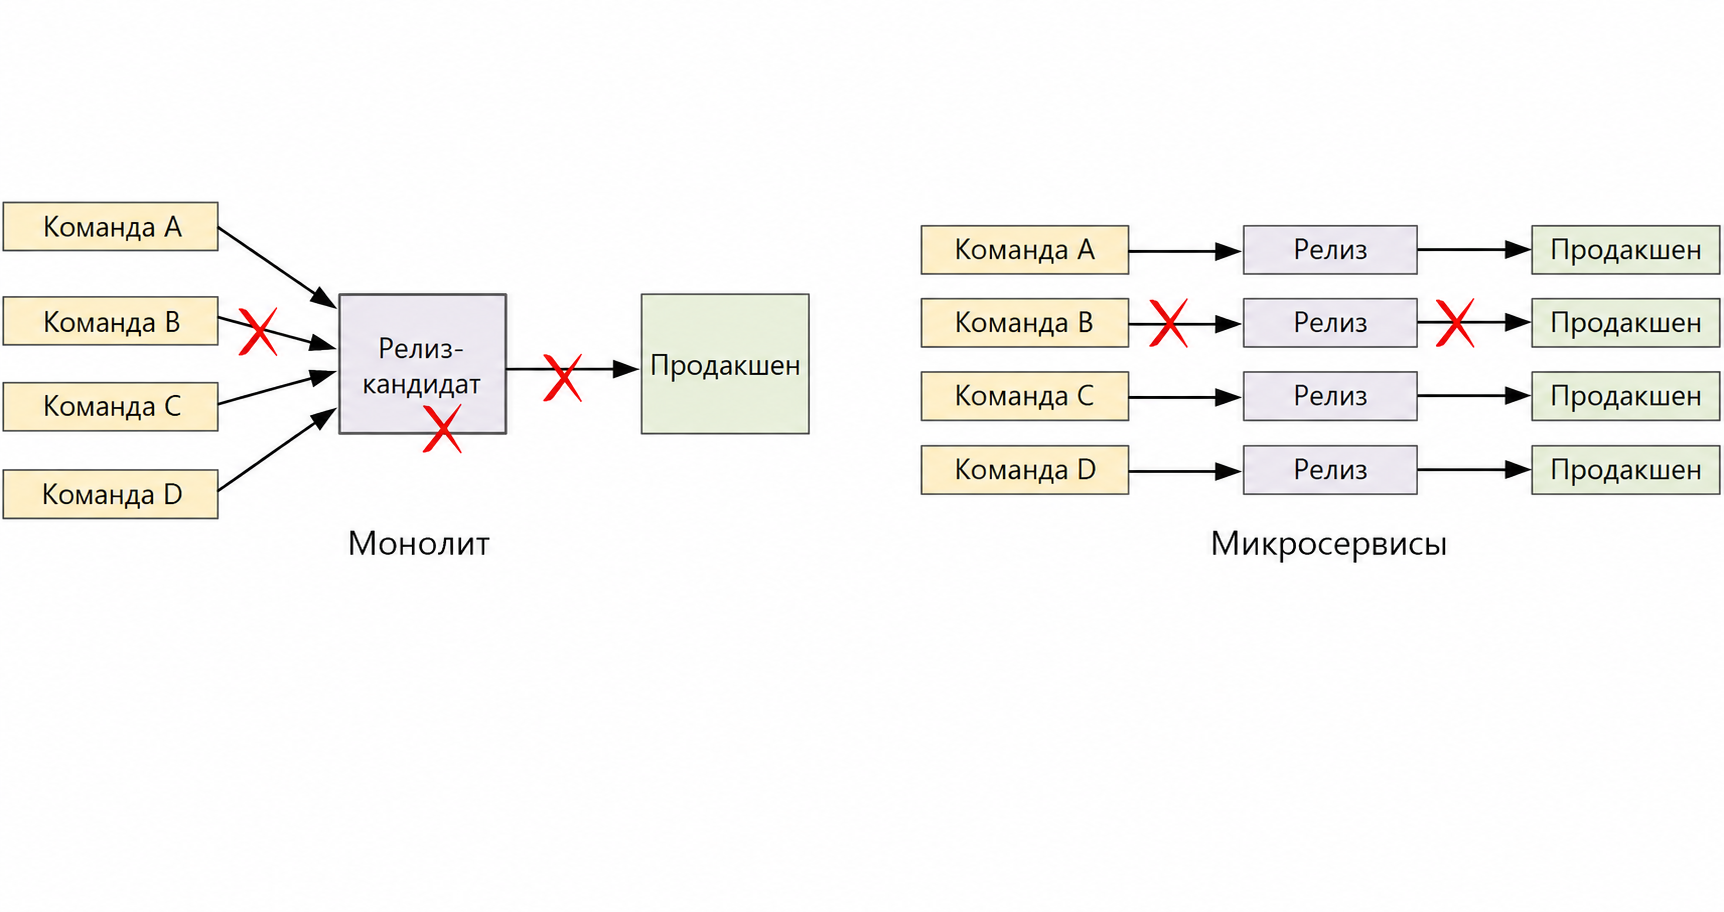
Принцип 3. Закрепление данных за сервисами
Помимо бизнес-логики, граница микросервиса также определяет данные, которыми он управляет. Льюис и Фаулер называют этот принцип Decentralized Data Management, то есть децентрализованным управлением данными. В микросервисной архитектуре каждый сервис отвечает за данные своей области и сам определяет, как их хранить и изменять.
Крис Ричардсон описывает такой подход в паттерне Database per Service. Постоянные данные каждого микросервиса должны быть закрыты от прямого доступа других сервисов. Благодаря этому внутреннее устройство хранилища можно менять, не заставляя остальные компоненты приспосабливаться к структуре его таблиц.
Например, один сервис отвечает за данные о заказах, а другой — за данные о доставках. Сервис доставки не должен напрямую читать или изменять внутренние таблицы сервиса заказов. Если ему нужны сведения о заказе, он получает их от сервиса заказов через предусмотренный интерфейс взаимодействия.
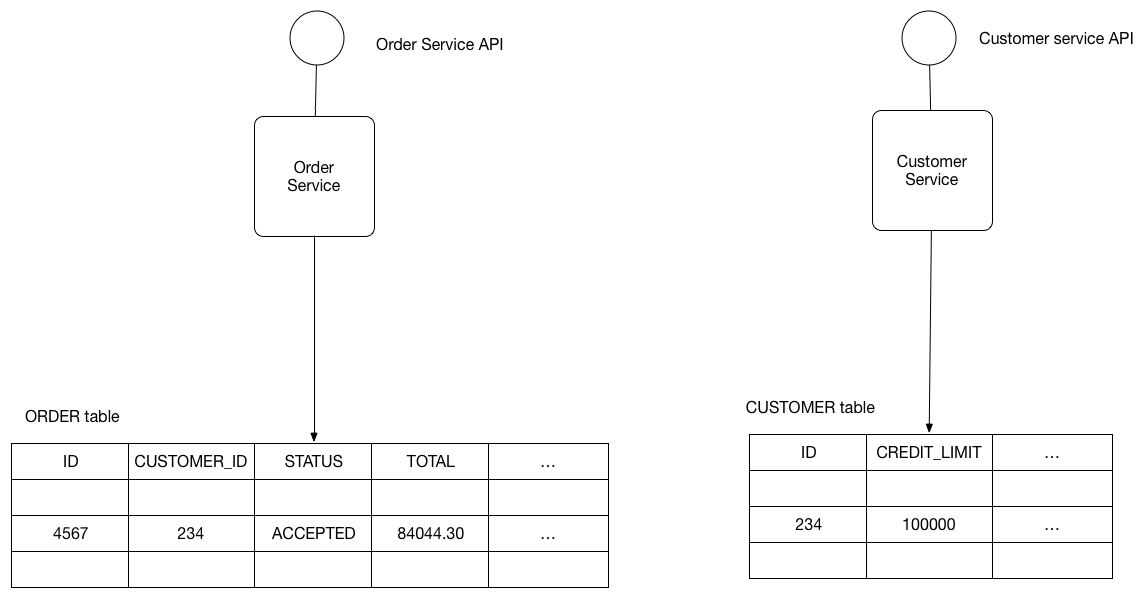
При этом Database per Service можно реализовать и без отдельного физического сервера базы данных для каждого микросервиса. Сервисам можно выделить собственные наборы таблиц или отдельные схемы в общей СУБД. Важно, чтобы каждый сервис контролировал доступ к своим данным, а остальные сервисы не обращались к ним напрямую. Такой подход также описан в рекомендациях Azure Architecture Center.
Но у данного подхода есть и обратная сторона. Если одна бизнес-операция затрагивает несколько сервисов, изменения придется согласовывать между независимыми хранилищами. Например, оформление заказа может одновременно затрагивать данные о самом заказе, оплате и доставке. Как обеспечивать согласованность таких изменений, разберем ниже в разделе о данных.
Принцип 4. Проектирование системы с учетом отказов
Микросервисы взаимодействуют по сети, поэтому при обращении к другому сервису нужно учитывать сетевые задержки, ошибки и его возможную недоступность. Другой сервис может не ответить, ответить с задержкой или временно оказаться недоступным.
Льюис и Фаулер выделяют подход Design for failure («Проектирование с учетом отказов»). Так как отдельные компоненты могут отказать, система должна обнаруживать такие ситуации и по возможности восстанавливаться после них.
Поэтому на этапе проектирования продумывают механизмы отказоустойчивости. Например:
- Паттерн Retry повторяет обращение к сервису, если произошел временный сбой и есть вероятность, что следующая попытка завершится успешно. Обычно количество попыток и интервалы между ними ограничивают, чтобы повторные запросы сами не увеличивали нагрузку на проблемный сервис.
Если после заданного количества попыток операция так и не выполнена, приложение прекращает повторные обращения и обрабатывает ее как неуспешную.
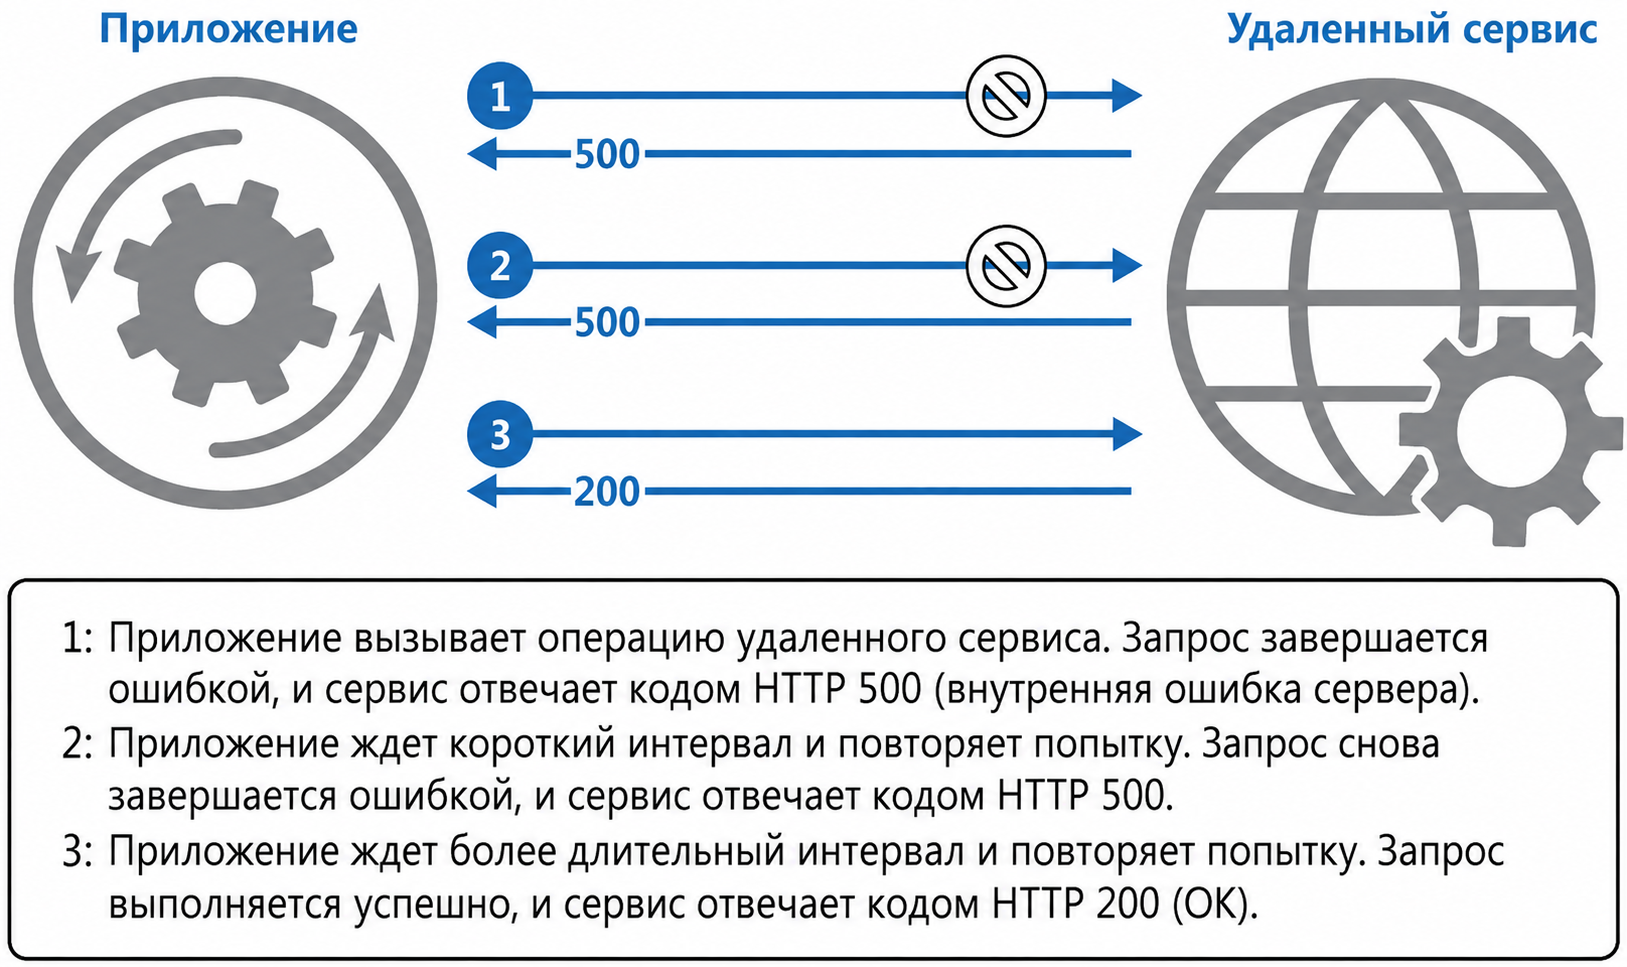
Важно, что, если операция изменяет данные, нужно учитывать ее идемпотентность. То есть нужно понимать, приведет ли повторное выполнение операции к тому же результату, что и единичное. Если операция неидемпотентна, повторный вызов может, например, создать дубликат заказа или повторно списать деньги. В таких случаях нужны дополнительные механизмы защиты от повторной обработки, например уникальный идентификатор запроса или проверка дубликатов.
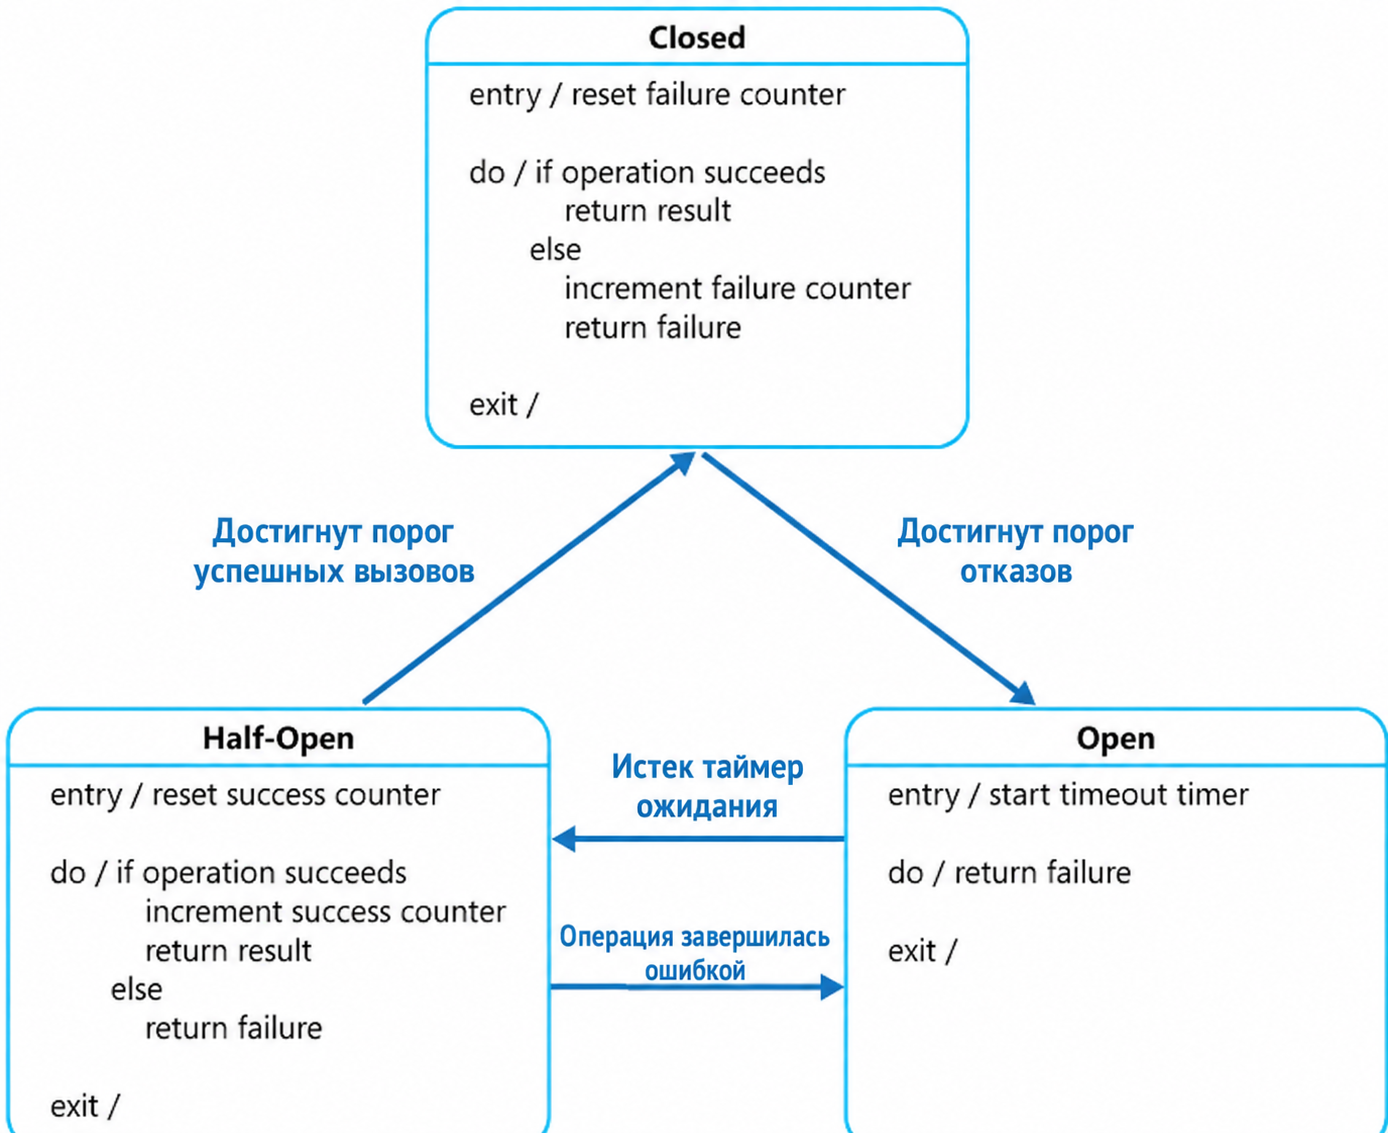
- Паттерн Circuit Breaker нужен для ситуаций, когда зависимый сервис систематически продолжает отвечать ошибками или вообще не отвечает. После того как количество неудачных обращений достигает заданного порога, Circuit Breaker временно блокирует новые вызовы.
Через некоторое время Circuit Breaker пропускает ограниченное количество пробных запросов. Если они проходят успешно, обращения возобновляются. Если сервис по-прежнему недоступен, вызовы снова блокируются.
- Паттерн Bulkhead изолирует ресурсы, которые используются для работы с разными сервисами. Например, для обращений к сервисам A, B и C можно выделить отдельные пулы соединений.
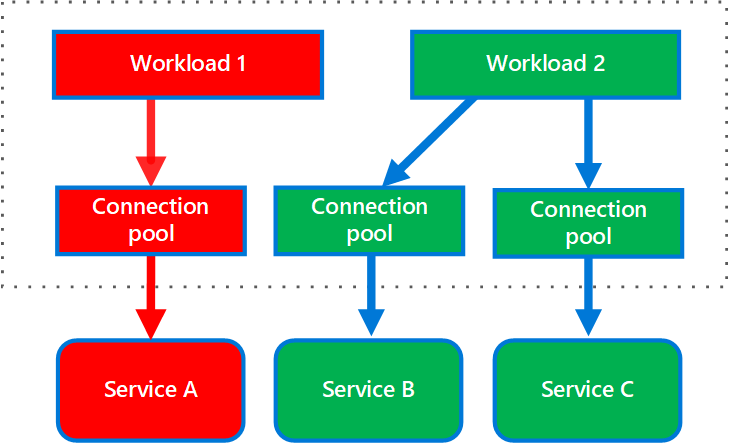
Если сервис A перестанет отвечать и все соединения из его пула будут в состоянии ожидания, это не исчерпает ресурсы, предназначенные для сервисов B и C. Приложение сможет продолжить работу с ними.
Таким образом, проблема одного зависимого сервиса остается внутри выделенной ему части ресурсов и не приводит к отказу остальных взаимодействий.
Принцип 5. Автоматизация инфраструктуры и наблюдаемость
Чем больше в системе независимо развертываемых компонентов, тем сложнее вручную ими управлять. Льюис и Фаулер выделяют подход Infrastructure Automation («Автоматизация инфраструктуры») как одну из характерных черт микросервисной архитектуры. Сборку, тестирование и развертывание сервисов стараются автоматизировать, чтобы выпуск каждого изменения не требовал большого количества ручных операций.
Для автоматизации этапов развертывания сервисов используют CI/CD. Приложение можно упаковать в контейнер с помощью Docker, а для запуска и управления большим количеством контейнеров использовать оркестратор Kubernetes.
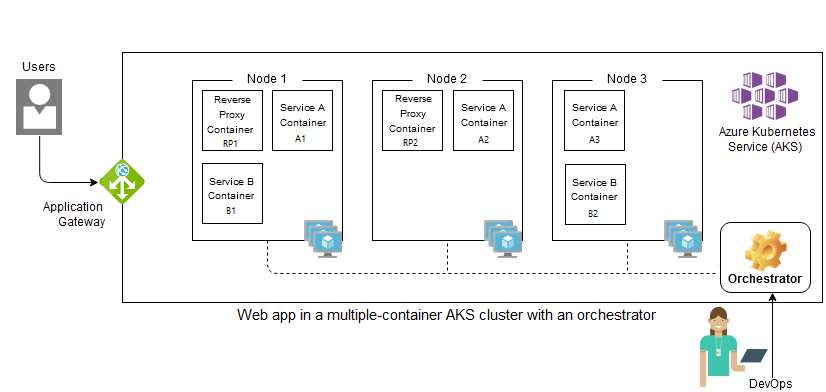
В микросервисной архитектуре также важна наблюдаемость (Observability).
Например, пользователь оформляет заказ. Order Service создает заказ и обращается к Payment Service, тот проводит оплату, после чего Notification Service должен отправить подтверждение. Пользователь заплатил деньги, но письмо не получил. Причина может быть в любом из сервисов или во взаимодействии между ними.
Чтобы найти проблему, используют такие источники:
- Логи фиксируют отдельные события внутри сервисов (полученный запрос, выполненная операция или ошибка).
- Метрики показывают состояние системы в числовых критериях (время ответа, количество запросов, частота ошибок, загрузка ресурсов).
- Распределенная трассировка связывает операции разных сервисов в одну цепочку и позволяет проследить путь конкретного запроса по системе.
Трассировка поможет определить, на каком сервисе прервалась обработка запроса, лог этого сервиса — увидеть конкретную ошибку, а метрики — понять, был ли это единичный сбой, или проблема затронула множество запросов.
Как микросервисы общаются между собой
После того как границы микросервисов определены, нужно решить, как они будут обмениваться данными. Взаимодействие между сервисами можно организовать синхронно или асинхронно. Также нужно спроектировать способ, которым к системе будут обращаться внешние клиенты.
API Gateway определяет, как внешние клиенты обращаются к системе, а синхронное и асинхронное взаимодействие описывают способ обмена данными между сервисами.
API Gateway
Если приложение состоит из множества микросервисов, внешнему клиенту не обязательно знать адрес каждого из них. Для этого используют единую точку входа в систему — API Gateway. Шлюз принимает запрос клиента и направляет его нужному сервису или нескольким сервисам.
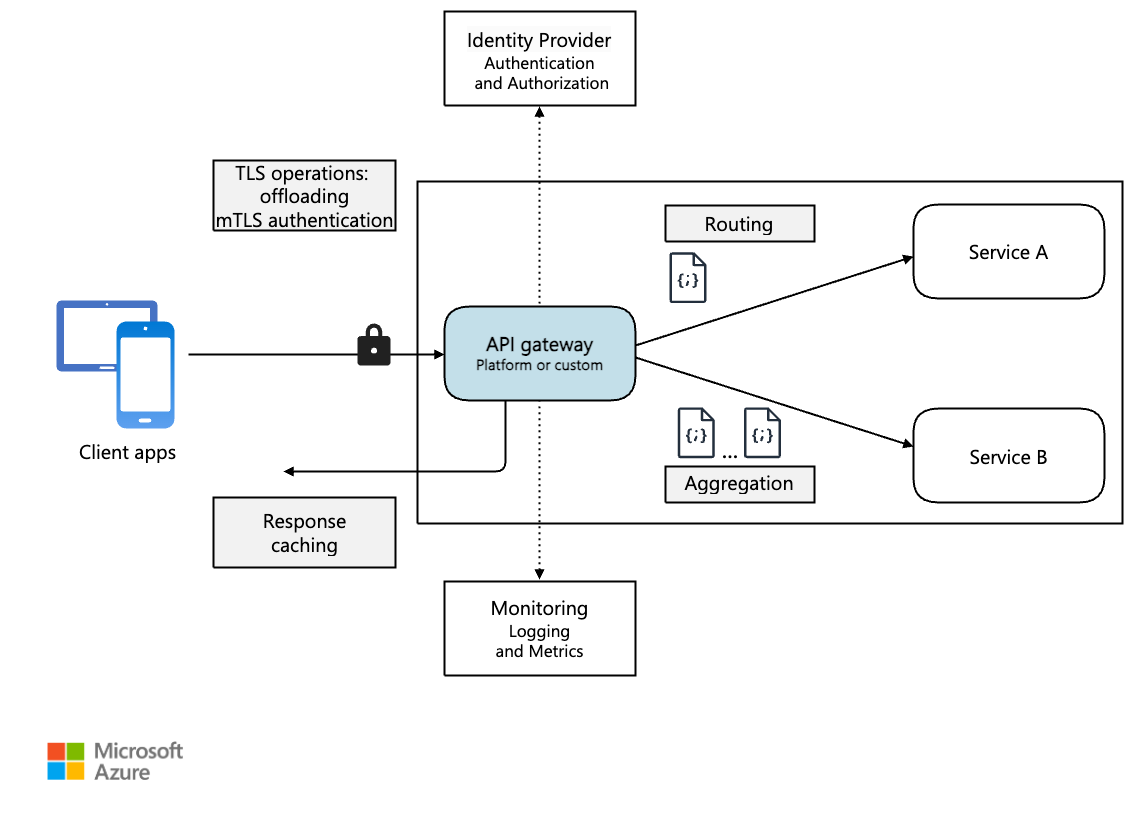
Gateway скрывает от клиента внутреннюю топологию сервисов.
Синхронное взаимодействие
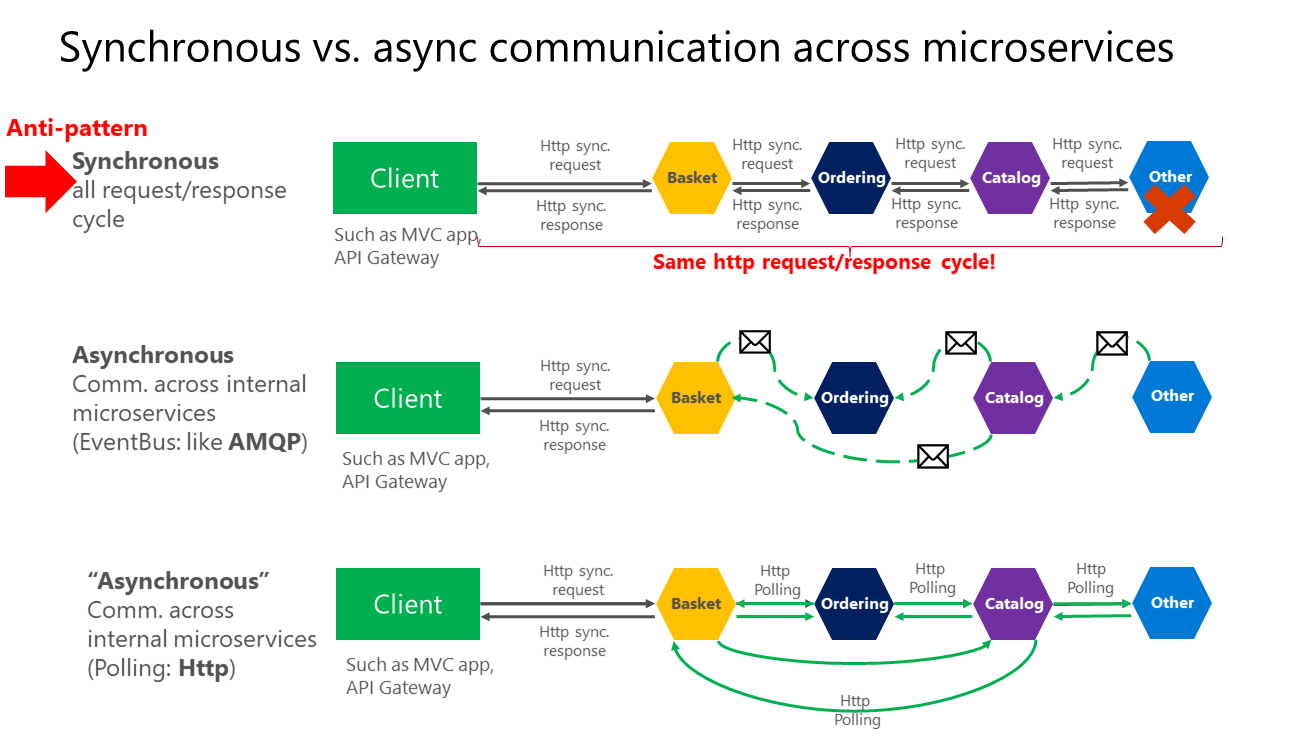
При синхронном взаимодействии один микросервис отправляет запрос другому и ждет ответ, прежде чем продолжить свою работу.
Microsoft описывает это как вызов API по HTTP или gRPC: сервис-отправитель продолжает операцию после того, как получит ответ от другого сервиса.
Для такого обмена можно использовать HTTP и REST API. Либо gRPC, с помощью которого один сервис может напрямую вызывать операции другого.
Например, при оформлении заказа сервис заказов может отправить запрос сервису оплаты и дождаться результата. Сервис заказов не должен считать оплату успешной, пока сервис оплаты не подтвердил ее.
У синхронного взаимодействия есть недостаток: вызывающий сервис зависит от скорости и доступности того, к кому обращается. Если модуль оплаты отвечает медленно, сервис заказов тоже будет дольше ждать результата. Если модуль оплаты недоступен, операция не получит от него ответ и без дополнительных механизмов обработки отказов может завершиться ошибкой.
Microsoft рекомендует избегать лишних синхронных зависимостей между микросервисами и не создавать длинную цепочку синхронных вызовов. Тогда лучше выбрать асинхронное взаимодействие.
Асинхронное взаимодействие
При асинхронном взаимодействии сервис отправляет сообщение или событие, но не обязан ждать, пока другой компонент его обработает. Между ними обычно находится брокер сообщений (например, RabbitMQ) или платформа потоковой обработки (например, Apache Kafka).
- Паттерн Publisher — Subscriber
Если одно событие должны получать несколько независимых сервисов, можно использовать паттерн Publisher — Subscriber («Издатель — подписчик»). В нем издатель — это сервис, который создает и публикует событие, а подписчики — сервисы, которые подписываются на интересующие их события и обрабатывают их.
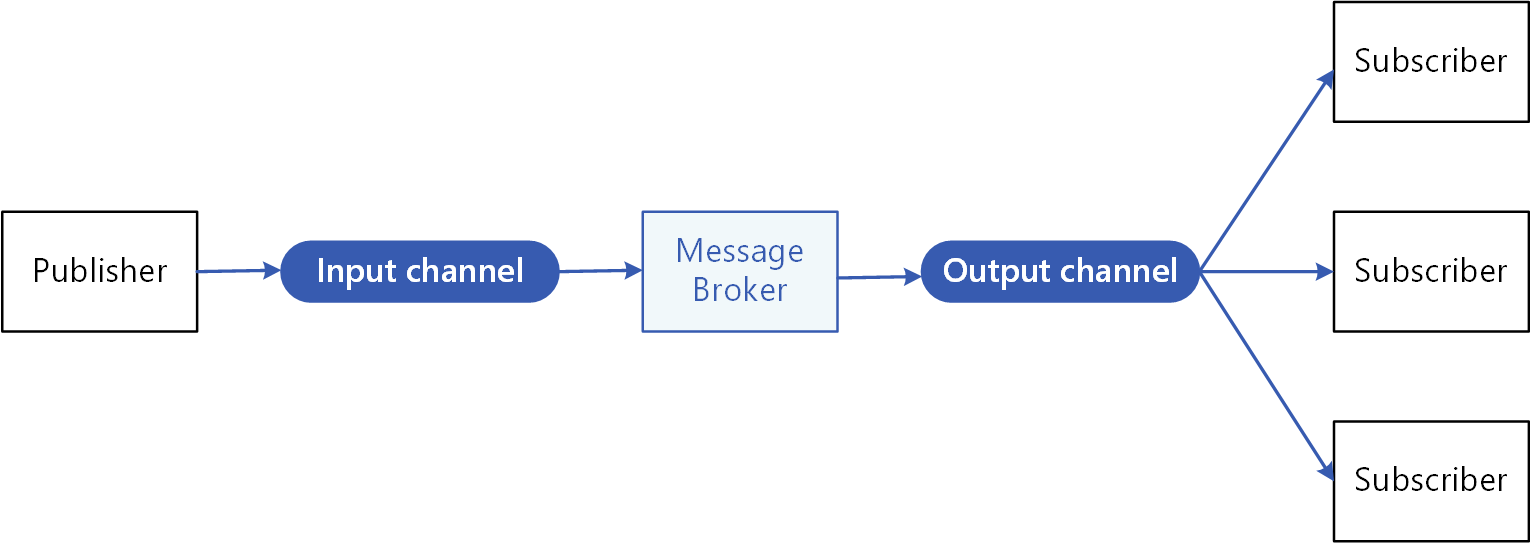
Издателю не нужно знать, какие именно сервисы получат событие, и обращаться к каждому из них отдельно. Он передает событие через посредника (например, брокер сообщений), а тот доставляет его заинтересованным подписчикам.
Например, после создания заказа Order Service может опубликовать событие OrderCreated. На него могут быть подписаны Payment Service, Notification Service и Warehouse Service. Каждый из них получает событие и выполняет свою часть работы независимо от остальных. К событию можно подключить нового подписчика, не добавляя еще один прямой вызов в сервис заказов.
- Паттерн Competing Consumers
Если сообщений много и их можно обрабатывать независимо друг от друга, используют паттерн Competing Consumers («Конкурирующие потребители»). В нем несколько потребителей получают сообщения из одной очереди и обрабатывают их параллельно. При этом каждое сообщение передается одному из потребителей, а не всем сразу.
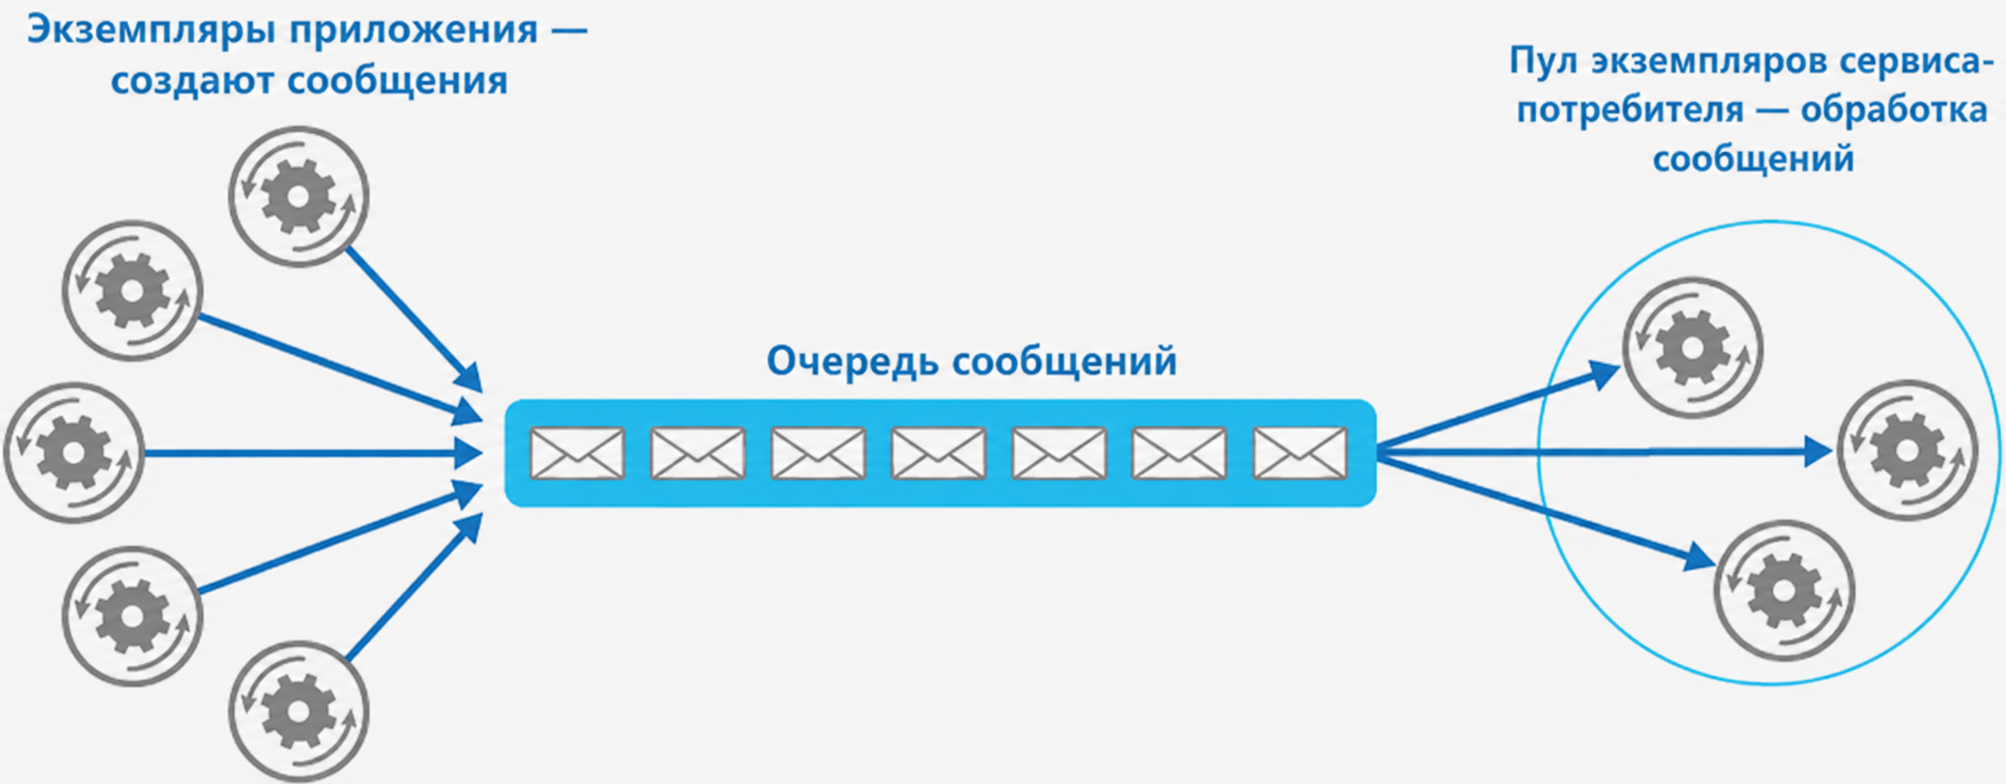
В этом отличие Competing Consumers от Publisher — Subscriber. В паттерне Publisher — Subscriber одно событие получают все заинтересованные подписчики, а в Competing Consumers несколько экземпляров одного обработчика конкурируют за сообщения из общей очереди.
Например, в очереди находятся задачи на отправку уведомлений. Если один экземпляр Notification Service не успевает их обрабатывать, можно запустить несколько экземпляров сервиса. Каждый из них будет забирать из очереди свою задачу, поэтому несколько уведомлений смогут обрабатываться одновременно. Если один потребитель перестанет работать, сообщения смогут продолжить обрабатывать другие экземпляры сервиса.
- Паттерн Queue-Based Load Leveling
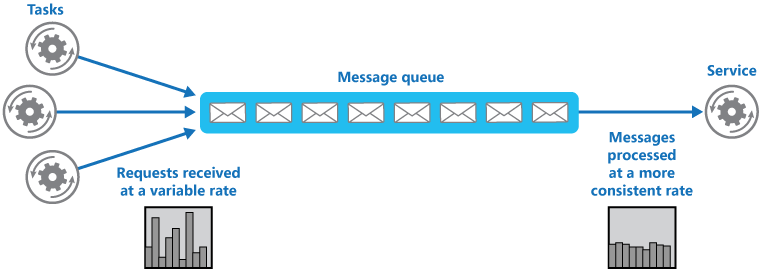
Если сообщения поступают быстрее, чем сервис успевает их обрабатывать, можно использовать паттерн Queue-Based Load Leveling («Балансировка нагрузки на основе очереди»).
Между отправителем и сервисом размещают очередь, которая временно хранит поступившие сообщения. Сервис забирает их из очереди с той скоростью, с которой способен обработать.
Например, интернет-магазин обычно получает несколько заказов в минуту, но во время распродажи их количество резко возрастает. Если каждый заказ сразу отправлять сервису обработки, резкий скачок нагрузки может его перегрузить. Очередь принимает новые задачи и накапливает их, а сервис постепенно обрабатывает сообщения.
Таким образом, скорость поступления сообщений не обязана совпадать со скоростью их обработки. Очередь выступает буфером и помогает сглаживать кратковременные пики нагрузки.
При асинхронном взаимодействии важно определить, какие гарантии доставки предоставляет используемая система:
- At-most-once (не более одного раза) — сообщение доставляется не больше одного раза. Повторной доставки нет, поэтому при сбое сообщение может быть потеряно.
- At-least-once (как минимум один раз) — система стремится доставить сообщение как минимум один раз, и из-за повторных попыток получатель может получить его несколько раз.
- Exactly-once (ровно один раз) — сообщение должно повлиять на результат обработки только один раз. Однако такая гарантия обычно действует только в определенных границах конкретной технологии. Например, брокер может гарантировать однократную обработку сообщения внутри своей системы, но эта гарантия не распространяется автоматически на запись в базы данных других сервисов или вызовы внешних API.
Паттерн Idempotent Consumer и Inbox
Если брокер работает по принципу at-least-once, одно сообщение может прийти повторно. Поэтому потребитель должен уметь определить, обрабатывал ли он его раньше.
Крис Ричардсон описывает паттерн Idempotent Consumer («Идемпотентный потребитель»), согласно которому повторная обработка одного сообщения не должна повторно изменять результат бизнес-операции.
Для этого, например, можно сохранять идентификаторы уже обработанных сообщений и проверять их при получении каждого сообщения. Такой механизм можно реализовать с помощью Inbox — хранилища входящих сообщений и информации об их обработке.
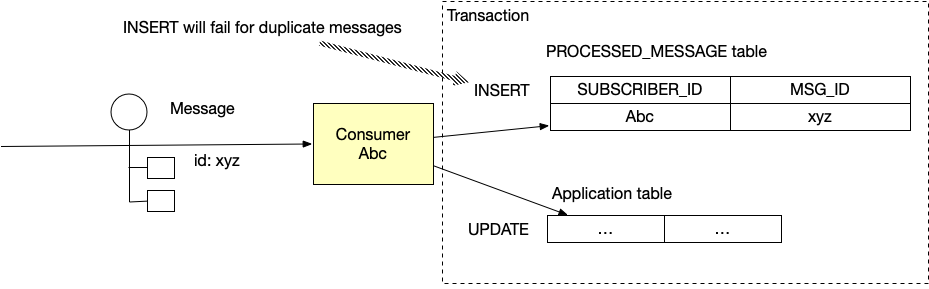
Например, потребитель сохраняет идентификатор каждого обработанного сообщения в отдельной таблице. Запись идентификатора и изменение бизнес-данных выполняются в одной транзакции. Если то же сообщение поступит повторно, попытка добавить его идентификатор завершится ошибкой из-за дубликата и бизнес-операция не будет выполнена второй раз. Такой подход позволяет сделать обработчик сообщений идемпотентным.
Как организовать данные в микросервисах
Когда микросервисы самостоятельно управляют своими данными, одна бизнес-операция может затрагивать несколько независимых хранилищ. Поэтому в микросервисной архитектуре существует проблема согласованности распределенных данных.
Согласованность данных
Представим оформление заказа:
- Order Service создает заказ со статусом ожидания оплаты.
- Payment Service проводит оплату.
- После подтверждения оплаты связанные сервисы получают соответствующее событие. Например, Order Service меняет статус заказа, а Delivery Service начинает оформление доставки.
Каждый сервис изменяет свои данные независимо. Поэтому изменения в разных частях системы могут применяться в разное время. Например, Payment Service уже может зафиксировать успешную оплату, а Order Service еще несколько мгновений будет хранить прежний статус заказа, пока не получит и не обработает событие.
Такой подход называют Eventual Consistency («Согласованность в конечном счете»). Данные не обязаны стать согласованными во всех сервисах в один и тот же момент, но после обработки всех связанных изменений система должна прийти к согласованному состоянию.
Saga
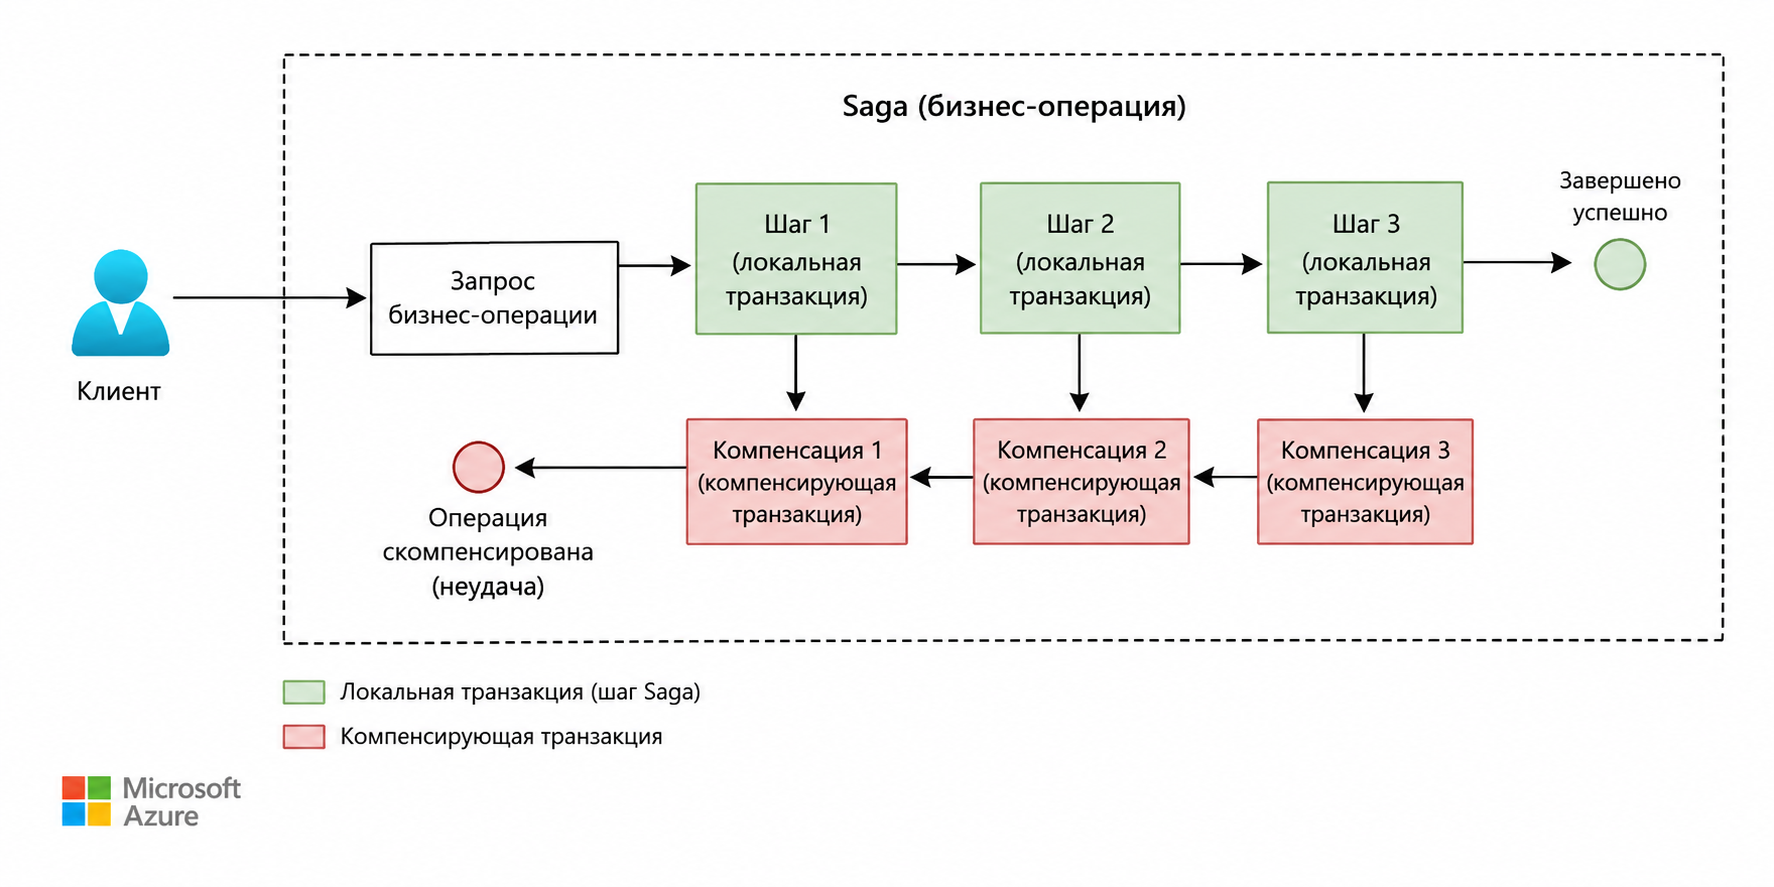
Если одна бизнес-операция требует изменить данные в нескольких сервисах, для управления ею можно использовать паттерн Saga. Он разбивает общую операцию на последовательность локальных транзакций. То есть каждый сервис изменяет только свои данные, после чего запускается следующий этап.
Например, оформление заказа может состоять из таких шагов:
- Order Service создает заказ.
- Payment Service проводит оплату.
- Delivery Service оформляет доставку.
Если все этапы выполняются успешно, операция завершается. Если один из этапов не удается выполнить, Saga может запустить компенсирующие транзакции, которые выполняют обратные или корректирующие действия для уже завершенных шагов.
Например, платеж уже прошел, но оформить доставку не удалось. В этом случае компенсацией может быть возврат платежа и перевод заказа в состояние «отменен».
Компенсирующая транзакция — это отдельная бизнес-операция, которая отменяет или корректирует эффект ранее выполненного шага и помогает вернуть систему в согласованное состояние. Для платежа такой операцией может быть возврат денег. Этот подход описан в паттерне Compensating Transaction.
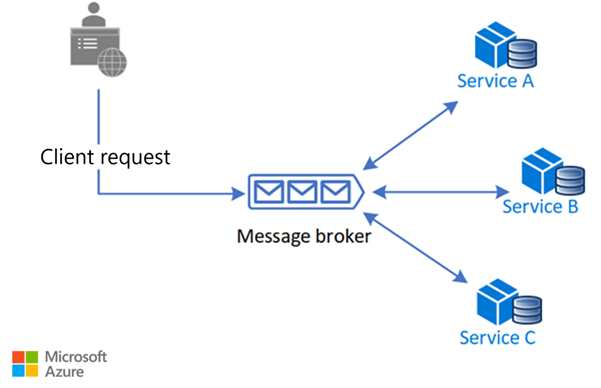
Saga может быть организована через паттерн хореографии, когда каждый сервис после выполнения своей операции публикует событие, которое запускает следующий этап в другом сервисе.
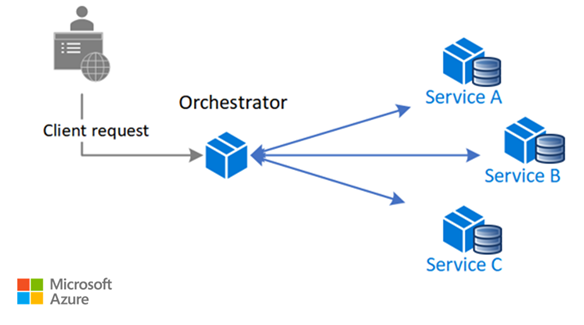
Или через оркестрацию, при которой последовательностью действий управляет отдельный координатор.
Transactional Outbox
При асинхронном взаимодействии возникает еще одна проблема. Сервису может потребоваться изменить данные в своей базе и сообщить об этом другим сервисам.
Например, Order Service должен:
- Сохранить новый заказ в базе данных.
- Отправить событие OrderCreated в брокер сообщений.
Если выполнять эти действия отдельно, между ними может произойти сбой, из-за которого данные и отправленные события окажутся несогласованными. Например, заказ уже сохранился, но приложение завершило работу до отправки события. В результате другие сервисы не узнают о новом заказе.
Возможна и обратная ситуация. Например, если сначала отправить событие, а затем сохранить данные, событие может уйти, хотя запись заказа завершится ошибкой. Проблему записи в две независимые системы называют dual write (двойная запись).
Для ее решения используют паттерн Transactional Outbox. Сервис сохраняет изменение бизнес-данных и запись о событии в одной транзакции базы данных. Например, вместе с созданием заказа он записывает событие OrderCreated в таблицу Outbox. Если транзакция завершается успешно, сохраняются обе записи. При ошибке не сохраняется ни одна.
После этого отдельный процесс читает новые записи из Outbox и отправляет соответствующие события брокеру сообщений. Поэтому событие не нужно отправлять в тот же момент, когда сохраняется заказ, ведь информация о нем уже находится в базе данных.
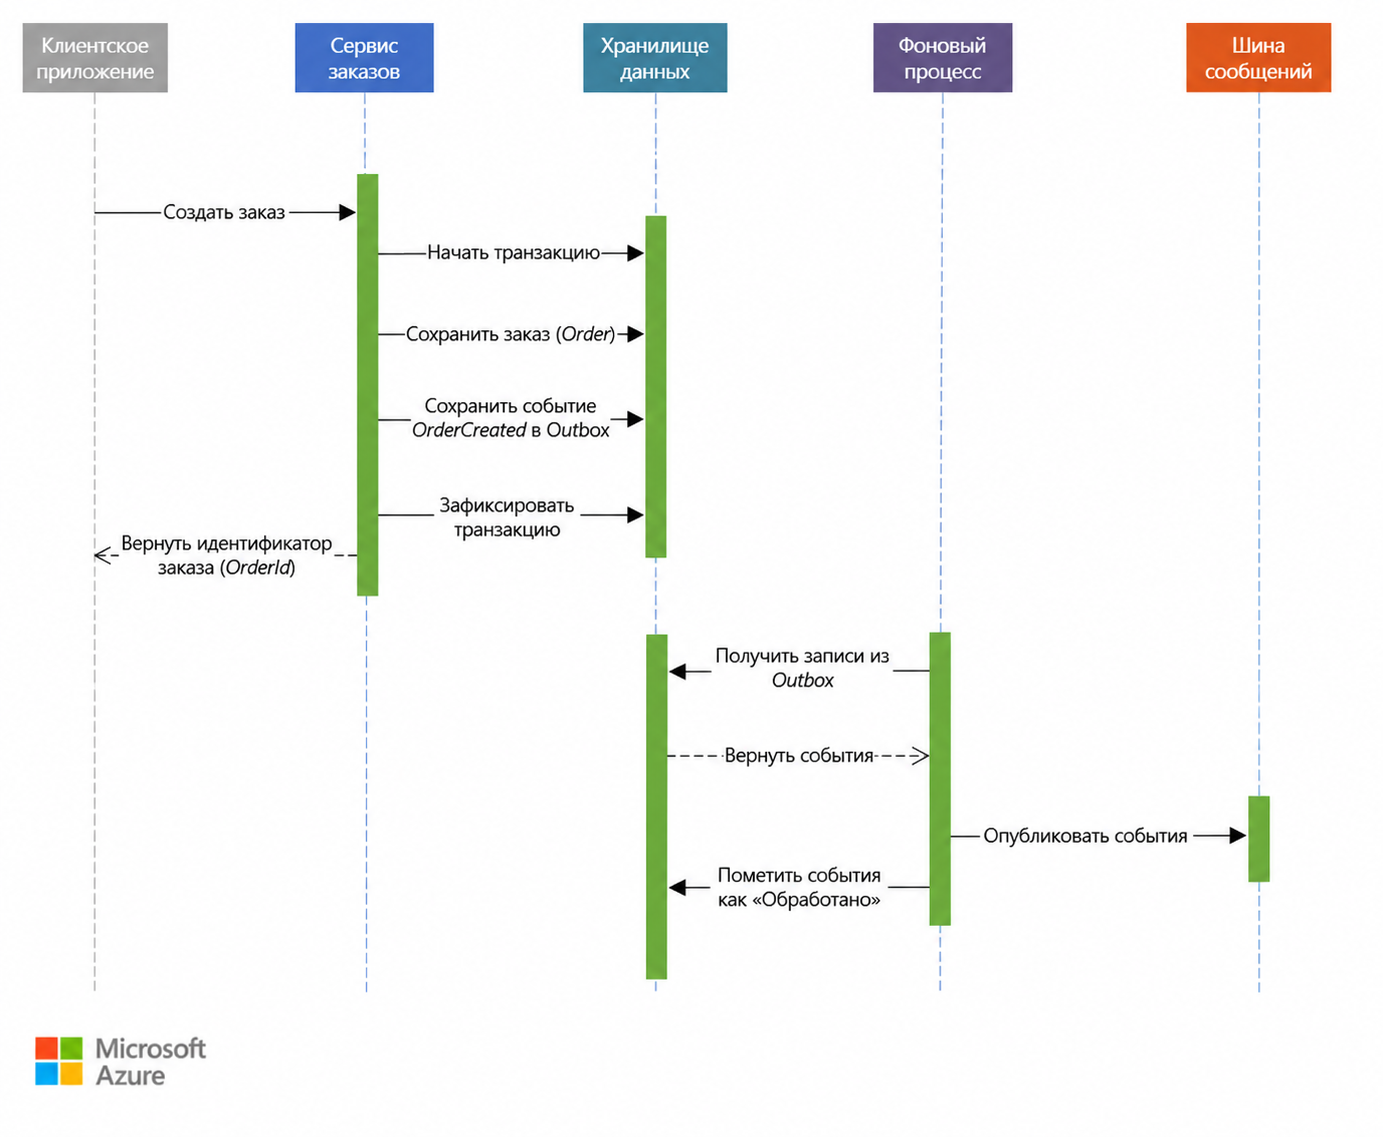
Работа паттерна Transactional Outbox: сохранение бизнес-данных и события в одной транзакции с последующей отправкой события в брокер сообщений. Источник
При этом Transactional Outbox не исключает повторной доставки события. Например, фоновый процесс может отправить событие брокеру, но завершиться до того, как пометит соответствующую запись в Outbox как обработанную.
После перезапуска событие будет отправлено повторно. Поэтому на стороне получателя по-прежнему нужна защита от дубликатов, например рассмотренные выше Idempotent Consumer и Inbox.
План проектирования микросервисной архитектуры
Мы разобрали, как определить границы микросервисов, распределить данные, организовать взаимодействие между сервисами и учесть возможные сбои. Проектирование можно свести к следующей последовательности действий:
- Определить бизнес-возможности и границы сервисов. Выделить самостоятельные задачи системы и определить, какой сервис будет отвечать за каждую из них. Для сложных систем границы можно искать через DDD и ограниченные контексты.
- Определить владельцев данных. Зафиксировать, какими данными управляет каждый сервис и через какие интерфейсы к ним смогут обращаться остальные. При этом можно ориентироваться на паттерн Database per Service.
- Спроектировать взаимодействие. Определить связи между сервисами, способ обращения внешних клиентов, например через API Gateway, и выбрать синхронный или асинхронный обмен между сервисами.
- Продумать согласованность данных. Определить, какие операции затрагивают несколько сервисов и как будут согласовываться изменения. Для распределенных операций могут понадобиться Saga и Transactional Outbox.
- Продумать сценарии отказов. Определить поведение системы при тайм-аутах, недоступности сервисов, ошибках и повторной доставке сообщений. В зависимости от проблемы используют Retry, Circuit Breaker, Bulkhead и идемпотентную обработку сообщений.
- Продумать работу под нагрузкой. Определить, какие сервисы могут испытывать повышенную нагрузку и как система будет ее распределять. Для асинхронной обработки могут использоваться Competing Consumers и Queue-Based Load Leveling.
- Продумать развертывание и наблюдаемость. Определить, как сервисы будут собираться и развертываться с помощью CI/CD, а также как система будет собирать логи, метрики и данные распределенной трассировки.