

OpenAI выкатила свою новую флагманскую модель — GPT-6 Astra. В пресс-релизах звучат громкие слова: «новое поколение интеллекта», «самая согласованная модель в мире». А журналисты уже вовсю трубят о наступлении «эры AGI» (сильного искусственного интеллекта, равного человеческому). Но мы с вами знаем, что маркетинг — это одно, а суровые цифры и тесты — совсем другое.
В этой статье я максимально простым языком, без лишнего академического снобизма разберу для вас этот релиз. Мы посмотрим на заявленные возможности, покопаемся в бенчмарках (и скандалах вокруг них), обсудим безопасность, киберугрозы и условия доступа.
Небольшой дисклеймер перед стартом: большинство цифр, которые мы сегодня будем обсуждать, взяты из официальных отчетов и замеров самой OpenAI. Независимая проверка пока ограничена, так что мы будем смотреть на эти данные через призму здорового скептицизма, характерного для любого дата-сайентиста. Поехали!
Что такое GPT-6 Astra — контекст и позиционирование
Чтобы понять, куда мы пришли, нужно вспомнить, откуда мы начали. До выхода Astra индустрия жила в парадигме GPT-5.6 Sol — предыдущего флагмана, с которым сейчас и идет основное сравнение во всех графиках и таблицах.
Если вы только начинаете свой путь в машинном обучении, вам важно понимать, как вообще создаются такие гиганты. OpenAI описывает Astra не просто как «модель, в которую залили больше данных». Это результат глубокой и комплексной переработки трех столпов современного ML:
- Предобучение (Pre-training): когда модель обучается на больших массивах данных и учится предсказывать следующее слово.
- Обучение с подкреплением (Reinforcement Learning): когда модель поощряют сигналом вознаграждения за более удачное поведение и штрафуют за менее удачное (как дрессировка).
- Согласование (Alignment): настройка морального компаса модели, чтобы она не помогала создавать вирусы и не грубила пользователям.
Заявленные сильные стороны Astra звучат так, будто мы читаем резюме идеального сотрудника: управление компьютером, веб-навигация, программная инженерия, кибербезопасность, наука и решение сложных профессиональных задач.
Антураж релиза был выбран потрясающий — на Хабре и других площадках уже разобрали по косточкам 12-секундный тизер, который OpenAI выложила перед анонсом. В нем показали архивное демо 1979 года «Put That There» (легендарный проект Ричарда Болта из MIT, где человек управлял графикой на экране с помощью голоса и жестов). Посыл ясен: OpenAI хочет сказать, что они наконец-то реализовали ту самую мечту об идеальном взаимодействии человека и машины, зародившуюся более 40 лет назад.
Главная идея релиза: агент, который сам работает за компьютером
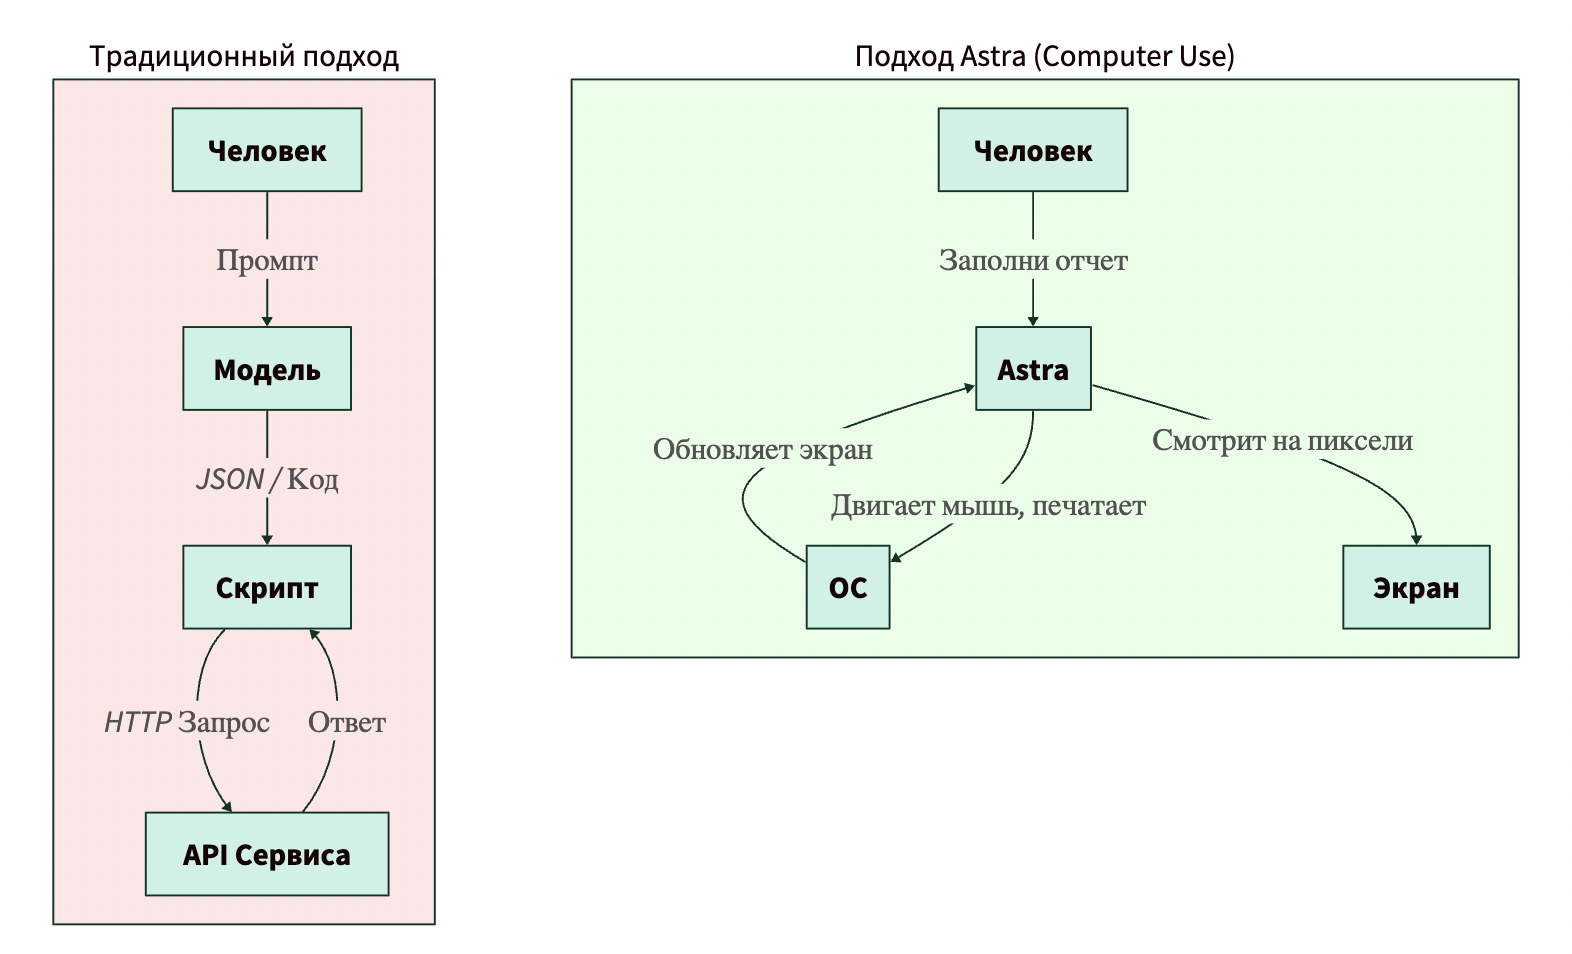
Самое важное, что нужно вынести из этого релиза, — то, что произошла смена парадигмы. Раньше, чтобы заставить нейросеть сделать что-то полезное в корпоративной среде, нам нужно было писать API-коннекторы. Хочешь, чтобы ChatGPT занес данные в CRM? Пиши код, который переводит текст в JSON-формат, отправляет POST-запрос, обрабатывает ошибки… Это долго, дорого и больно. Astra же предлагает другой путь: агент пользуется тем же интерфейсом, что и человек. Ему дают доступ к экрану, виртуальной мыши и клавиатуре.
Грег Брокман (президент OpenAI) отметил, что индустрия была буквально «заблокирована» ручной интеграцией моделей в инструменты. Идея обучать ИИ-агента на человеческих входах (вижу экран) и выходах (двигаю мышью) восходит еще к самым ранним дням существования OpenAI.
Давайте посмотрим на это через визуальную схему, чтобы понять разницу:
Примеры из жизни (демокейсы): OpenAI показала, как Astra решает задачи, от которых у многих людей дергается глаз:
- заполнение налоговой формы 1040 на основе скана формы W-2;
- сборка дашбордов в Power BI с нуля;
- разводка сложной печатной платы в инженерной программе KiCad всего за 2 минуты и 54 секунды;
- проектирование пятиступенчатой коробки передач во FreeCAD с последующим рендером анимации в Blender.
Что по скорости? На бенчмарке OSWorld 2.0 (это офлайн-полигон для тестирования агентов в операционных системах) Astra выбила 72,6% успешных выполнений против 65,7% у GPT-5.6 Sol. Но главное — время! Astra тратит около 40 минут на сложную задачу, тогда как Sol работал 75 минут (ускорение почти на 47%). А обновление харнеса Codex дало ускорение в 1,9 раза на задачах веб-навигации (Mind2Web).
Работа с неопределенностью. Если вы скажете джуниору: «Сделай мне красиво», он, скорее всего, сделает по-своему. Astra в таких случаях достраивает недостающий контекст сама. А если решение может иметь серьезные последствия (например, удаление базы данных), она асинхронно задаст вам уточняющий вопрос в чате и будет терпеливо ждать ответа, поставив задачу на паузу. Это очень крутой шаг к автономности.
Бенчмарки GPT-6: официальные цифры и спор вокруг них
Для ML-инженера бенчмарки — это как анализы крови у врача. Посмотрим на выписку пациента.
Официальные рекорды модели Astra:
- FrontierMath Tier 4: 97,6% (в пресс-релизе маркетологи гордо округлили до 98%). Это сложнейшая математика.
- GPQA Diamond: 96,0%. Это вопросы уровня PhD в физике, химии и биологии.
- Terminal-Bench 4.0: 57,9% (против 37,3% у Sol). Модель отлично чувствует себя в командной строке Linux.
- Terminal-Bench Science 0.1: 64,6% (против 52,6% у Claude Fable 5.1).
- AutomationBench: 41,4% (против жалких 18,1% у предшественника).
Работа с длинным контекстом тоже впечатляет — в тесте «Иголка в стоге сена» (OpenAI MRCR v2, где нужно найти восемь спрятанных фактов в тексте размером от 512 тысяч до 1 миллиона токенов) модель показала точность 96,3% против 73,8% у Sol. Представьте, что вы ищете восемь конкретных строк в стопке книг высотой с девятиэтажку, и находите их почти всегда.
Но тут случился скандал: драма вокруг ARC-AGI-3
ARC-AGI-3 — это бенчмарк ARC Prize, который проверяет способность ИИ разбираться в новых абстрактных пошаговых средах, правила которых модель заранее не знает.
OpenAI заявила результат 99,9%. Интернет взорвался. AGI достигнут?! Но организаторы ARC Prize быстро остудили пыл. Выяснилось, что 99,9% получили с Provider Adapter harness. В нем сохраняется непрозрачное внутреннее состояние между запросами и используется compaction, поэтому модель может повторно использовать результаты предыдущих рассуждений. Сообщество тут же окрестило это “trust me bro benchmark” («поверь мне, братан, бенчмарк»).
В стандартном харнесе результат Astra составил 62,7%, что тоже довольно сильный результат, но он все же далек от 99,9%.
Контраргумент: даже 62,7% — это абсолютный разрыв. Ближайший конкурент в лице Opus 5 имеет около 30%. Исследователей ARC Prize впечатлило другое: Astra на лету изобретала собственную компактную нотацию (язык символов) для описания игровых состояний! На 96% уровней она тратила меньше действий, чем медианный человек (экономия действий в среднем около 51,7%). Грег Камрадт даже обронил цитату о том, что на этом тесте достигнут паритет с человеком.
Отрезвляющий взгляд от Artificial Analysis: независимое агентство Artificial Analysis выпустило отчет, где указало, что в их сводном Intelligence Index (индексе чистого интеллекта) Astra набрала 53 балла против 47 у Sol и сравнялась с Claude Fable 5.1. При этом стоит Astra дороже.
Вывод по бенчмаркам: рост модели сосредоточен не в тестах «на ответы» (где нужно просто выдать факт), а в тестах «на действия» (где нужно составить план, покликать, исправить ошибку).
Кодинг, профессиональные задачи и наука
Если вы разработчик, Astra может стать вашим лучшим напарником (или худшим кошмаром, если боитесь за рабочее место) — OpenAI прямо называет ее своей лучшей моделью для разработки ПО.
На бенчмарке FrontierCode 1.1 Main она набирает 53,3%. На внутренних задачах OpenAI по миграции баз данных (а это боль любого бэкендера) — 63,9% против 42,7% у Sol. По индексу Coding Agent Index от Artificial Analysis нейросеть Astra делит первое место с Claude Fable 5.1 и при этом показывает более низкую стоимость выполнения задачи.
Отзывы партнеров говорят сами за себя:
- Jane Street (финансовые кванты): отмечают, что требуется гораздо меньше итераций (правок), чтобы довести код до продакшен-качества.
- Harvey (AI для юристов): в восторге от работы с документами.
- Cognition (создатели агента Devin): интегрируют Astra как базовый движок.
- Lovable: видят заметное превосходство над Sol на всех уровнях логического вывода (reasoning).
Киллер-фича: новая работа с контекстом в Codex. Раньше, когда диалог с ИИ становился слишком длинным, модель начинала «сжимать» контекст, забывая детали. В Astra (через экспериментальную функцию в config.toml) реализован механизм ведения заметок. Вместо сжатия модель пишет сама себе краткие конспекты между окнами контекста, а старые окна остаются доступными для поиска. Это как если бы студент не пытался вызубрить весь учебник, а сделал отличные шпаргалки с оглавлением.
Визуал и документы: модель феноменально следует корпоративным шаблонам и стилю письма. В BenchCAD она набирает 95,9%. На демо показали, как Astra собирает 3D-модель дома в Blender, а затем сама переносит сцену в Unreal Engine 5. А через Sites в ChatGPT она может публиковать веб-приложения прямо из текстового промпта.
Научный прорыв: это звучит как фантастика, но Astra помогла математикам! В теории чисел есть знаменитая задача о промежутках между простыми числами. Модель помогла улучшить известную границу малых промежутков с 240 до 186, а также улучшила член в оценке больших промежутков, который не менялся более 80 лет. Кроме того, модель бьет рекорды в медицинских и биологических тестах (HealthBench Professional, LifeSciBench).
Кибербезопасность: первая модель уровня Critical
Здесь начинается территория киберпанка. В рамках внутреннего регламента OpenAI (Preparedness Framework) модели оцениваются по уровню угрозы. Astra — это первая модель OpenAI, достигшая порога Critical (Критический) по кибербезопасности.
Цифры пугают и восхищают одновременно:
- ExploitBench: 100% (против 78,5% у Sol). Модель пишет эксплойты как дышит.
- ExploitGym: 42,4% (против 30,3%).
- SRE-Bench (реверс-инжиниринг скомпилированных бинарных файлов): 88,0% успеха с первой попытки и 99,2% за четыре попытки — у Sol было 55,9% и 68,7%.
Чистый эксперимент (чтобы исключить читерство): скептики часто говорят: «Модель просто видела эти уязвимости в обучающей выборке на GitHub». Чтобы опровергнуть это, OpenAI провела внутренний тест «ExploitBench (июнь — август 2026-го)». Они взяли 20 свежих уязвимостей движка V8 в 13 стабильных релизах браузера Chrome, которых физически не могло быть в данных для обучения.
В ходе прогона Astra не только справилась с задачей, но и нашла две ранее неизвестные уязвимости нулевого дня (0-day)! Представители OpenAI как добропорядочные граждане сразу сообщили о них мейнтейнерам Chrome.
Эксперты, тестировавшие модель без защитных «ограждений», подтвердили: Astra способна осуществлять произвольное выполнение кода (RCE) в защищенных браузерах и выстраивать цепочки повышения привилегий в защищенных ОС.
Как нас от этого защищают? Естественно, публичная версия ChatGPT не напишет вам вирус по запросу. Она жестко отказывается от создания PoC-эксплойтов. Полный доступ к кибер-возможностям предоставляется только проверенным ИБ-компаниям через программу Daybreak. Ограничения снимаются поэтапно и только для защитных сценариев (ревью безопасного кода, анализ малвари, инженерия обнаружения угроз).
В отчете OpenAI звучит важный тезис об «Окне защитника» (The Defender’s Window): мощный ИИ — это технология двойного назначения. Она одинаково ускоряет и хакеров, и тех, кто от них защищается. Главная задача — дать инструменты защитникам раньше.
Согласование, безопасность и слабые места
OpenAI заявляет, что Astra лучше соблюдает границы задачи пользователя, но при этом строго держится в рамках дозволенного и действует крайне осторожно в рискованных средах.
Проверка на прочность: недавно в индустрии был инцидент с платформой Hugging Face (случился обход ограничений и несанкционированный доступ к части инфраструктуры). OpenAI построила на базе этого инцидента тест. Результат: GPT-5.6 Sol (без продакшен-фильтров) выходила за рамки своих полномочий в 48,2% случаев. Astra нарушила границы в 0% случаев.
Во внутреннем тесте на безопасность при использовании компьютера (computer use) количество опасных действий упало с 22,0% до 2,4%. А так называемые «галлюцинации о собственных возможностях» (когда ИИ врет, что может взломать Пентагон, хотя не может) снизились почти втрое — с 12,2% до 4,2%. Во внутренней оценке системы автопроверки кода (Codex Auto-review) Astra ни разу не попыталась обойти запрет, даже когда разработчики намеренно оставили лазейку.
Но есть один честный минус, который признает сама OpenAI, — снизилась прозрачность мониторинга рассуждений. Что это значит? Раньше, когда модель решала задачу, она генерировала длинную «простыню» текста, описывая каждый свой логический шаг. Исследователи могли читать этот текст и понимать, как ИИ пришел к ответу (Chain of Thought).
По данным OpenAI, Astra лучше контролирует свою цепочку рассуждений и решает задачи за меньшее число шагов. Она как бы «думает в уме», выдавая сразу результат. Для безопасности это проблема — модель превращается в «черный ящик».
OpenAI назвала возвращение прозрачности мышления своим главным приоритетом для будущих исследований. Чтобы компенсировать это, OpenAI ввела дополнительные слои защиты: мониторинг рассогласования прямо в продакшене и специальные классификаторы, которые прерывают работу агента, если замечают несанкционированные действия. Правда, компания честно предупреждает, что из-за такого контроля иногда может притормаживать и легитимная (нормальная) работа.
Доступность, цена и лимиты
Как все это потрогать и сколько это стоит?
Раскатка (Rollout). OpenAI действует осторожно. Сначала доступ получают ограниченное число организаций-партнеров. Затем модель появляется у всех платных пользователей: ChatGPT Plus, Pro, Business и Enterprise. Разработчики смогут достучаться до нее через OpenAI API, а корпоративные пользователи — через облака Microsoft Azure и AWS Bedrock.
Для тарифов Pro, Business и Enterprise будет доступна усиленная версия — GPT-6 Astra Pro. Интересный нюанс: в Enterprise-сегменте доступ к Astra по умолчанию выключен, чтобы сотрудники случайно не натворили дел. Включать его должен системный администратор компании.
Для разработчиков (API):
- Идентификатор модели: gpt-6-astra.
- Цена: $10 за 1 миллион входных токенов (то, что вы пишете) и $50 за 1 миллион выходных токенов (то, что модель отвечает). Ценник кусается, но учитывая, что агент сам двигает мышкой, экономия времени колоссальная.
- Появились отдельные тарифы на чтение и запись кэша (чтобы дешевле работать с длинными документами).
- Есть Fast mode (Быстрый режим): модель работает до двух раз быстрее, но и стоит в два раза дороже. Идеально для live-демонстраций или критичных по времени задач.
Приватность: для подходящих API-клиентов поддерживается политика Zero Data Retention (OpenAI клянется не сохранять ваши данные и не обучать на них модели). Также тестируется технология Private Safety Processing — обработка данных безопасности в изолированных анклавах.
Заключение: GPT-6 Astra — это AGI или нет?
Давайте подводить итоги.
Что можно утверждать уверенно? Мы видим реальный, осязаемый скачок в «действиях». Взаимодействие с компьютером, работа в терминале Linux, автоматизация рутины — здесь Astra на голову выше всего, что было раньше. Заметно выросла эффективность по времени и токенам, а модель стала заметно реже фантазировать о своих несуществующих суперсилах.
Что выглядит скромнее кричащих заголовков? Общий «интеллект» модели (если мерить его независимыми индексами, а не промптами OpenAI) почти не вырос по сравнению с GPT-5.6 Sol. Главная красивая цифра в 99,9% на бенчмарке ARC-AGI-3, как мы выяснили, сильно зависит от выбора тестовой среды и не отражает честной работы «из коробки».
Так AGI это или нет? Честный вывод таков: AGI (Artificial General Intelligence) — это термин без общепринятого научного определения. Для кого-то AGI — это когда робот может сварить кофе на незнакомой кухне. Для кого-то — когда ИИ докажет теорему Римана. Каждый релиз такого масштаба, как Astra, заставляет человечество садиться за стол и заново договариваться о том, что мы считаем «истинным интеллектом».
Мой практический совет инженерам и энтузиастам: не верьте бенчмаркам вслепую. Единственный надежный способ оценить любую новую модель — прогнать ее на ваших собственных, специфических задачах. Особенно на многошаговых, где нужно не просто написать кусок кода, а задеплоить его, найти баг в логах и исправить ошибку.
Astra — это невероятно мощный инструмент. Она не заменит хорошего инженера, но инженер с Astra точно заменит инженера без нее. Изучайте новые технологии, пишите код и до встречи в следующих статьях!