

Если вы интересовались машинным обучением, читали статьи на Хабре или смотрели решения соревнований на Kaggle, у вас могло сложиться одно стойкое впечатление. Кажется, что для любых табличных данных существует только один алгоритм — градиентный бустинг. Будь то XGBoost, LightGBM или отечественный CatBoost, новички (да и опытные специалисты) часто импортируют их по умолчанию, нажимают .fit() и получают отличный результат.
А зачем тогда нужны старые добрые линейные модели? Неужели линейная и логистическая регрессия стали просто академическим примером для первых лекций по ML?
В этой статье мы как инженеры разберем этот миф. Я поделюсь своим опытом и докажу вам, что линейные модели рано списывать со счетов. Мы разберем их анатомию, столкнем лбами с бустингом, напишем код с экспериментами и составим четкий чек-лист: когда дедушка машинного обучения легко побеждает современные ансамбли.
Почему бустинг стал «дефолтом», но линейные модели все еще живы
Будем честны: градиентный бустинг над решающими деревьями — это шедевр алгоритмической мысли. Его популярность абсолютно заслужена. Если у вас есть таблица с данными (клиенты банка, параметры недвижимости, телеметрия с датчиков), бустинг часто показывает высокое качество предсказаний практически из коробки. Он прощает нам лень: не нужно тщательно масштабировать признаки. Он сам найдет нелинейные зависимости и сам поймет, что возраст клиента нужно умножить на его доход.
Но в реальном продакшене (в отличие от Kaggle) метрика качества (Accuracy, ROC-AUC, RMSE) — это лишь одно из требований к модели. В бизнесе появляются такие факторы, как время ответа модели (latency), ограничения по оперативной памяти, требования регуляторов к прозрачности решений, необходимость дообучать модель в режиме реального времени на потоке данных.
Именно здесь бустинг, представляющий собой тяжеловесный ансамбль из сотен деревьев, начинает буксовать. А линейные модели, легкие, прозрачные, молниеносные и математически элегантные, словно скальпель хирурга, выходят на первый план.
Краткий ликбез: что такое линейные модели
Чтобы понять разницу, давайте вспомним, как работают линейные модели. Название говорит само за себя: мы пытаемся провести линию (или плоскость в многомерном пространстве), которая лучше всего описывает наши данные.
Линейная и логистическая регрессия
- Линейная регрессия решает задачу предсказания числа. Например, мы предсказываем цену квартиры. Гипотеза выглядит как взвешенная сумма признаков: Цена = w1 х Площадь + w2 х Расстояние_до_метро + b. Модель должна найти такие веса (w1,w2) и смещение (b), чтобы ошибка была минимальной.
- Логистическая регрессия решает задачу классификации (например, вернет ли клиент кредит или нет). Внутри это та же самая линейная комбинация, но обернутая в специальную функцию (сигмоиду), которая сжимает результат в диапазон от 0 до 1. На выходе мы получаем вероятность.
Обучение и функция потерь
Как модель понимает, какие веса правильные? Через минимизацию функции потерь с помощью алгоритма оптимизации. Один из способов — градиентный спуск.
Приведем пример из жизни. Представьте, что вы спускаетесь с горы с завязанными глазами. Вы щупаете землю ногой, понимаете, где уклон идет вниз (это градиент), и делаете туда шаг. Так же и модель шаг за шагом меняет веса, пока ошибка (разница между предсказанием и реальностью) не станет минимальной.
Регуляризация: L1, L2 и ElasticNet
Иногда модель так сильно хочет подстроиться под обучающие данные, что начинает придавать огромные веса бесполезным признакам (например, фазе луны при предсказании цены квартиры). Это называется переобучением. Чтобы этого избежать, используют регуляризацию — штраф за слишком большие веса.
- L2-регуляризация штрафует за квадраты весов. Заставляет веса быть маленькими, но не нулевыми. Как строгий начальник, который урезает всем премии пропорционально. В линейной регрессии модель с таким штрафом называется Ridge.
- L1-регуляризация штрафует за модули весов. Может занулять часть коэффициентов признаков. Отличный встроенный отбор признаков! Как начальник, который просто увольняет половину отдела. линейной регрессии модель с таким штрафом называется Lasso.
- Elastic Net — это комбинация обоих подходов, она сочетает L1- и L2-регуляризацию.
Что такое градиентный бустинг (для контекста)
Базовый кирпичик бустинга — решающее дерево, которое задает данным серию вопросов на «да/нет». Пример: возраст > 30? Если да, то доход > 100 тысяч?
Одно дерево может быть слабым и легко переобучается. Поэтому придумали ансамбли. Градиентный бустинг — это команда деревьев, которые обучаются последовательно.
Пример из жизни. Представьте команду игроков в гольф. Первый игрок бьет по мячу, но не докидывает до лунки 10 метров. Второй игрок подходит к мячу и пытается ударить ровно на эти оставшиеся 10 метров (для квадратичной ошибки это можно представить как обучение на остатках). Третий исправляет ошибку второго и так далее. Вместе они загоняют мяч точно в цель.
Современные библиотеки (XGBoost, LightGBM, CatBoost) — это просто оптимизированные, быстрые и умные реализации этой идеи. Они умеют работать параллельно, строить деревья особым образом и обрабатывать категориальные признаки.
Чем принципиально отличаются линейные модели и градиентный бустинг?
Давайте разберем отличия по ключевым осям.
Форма разделяющей поверхности
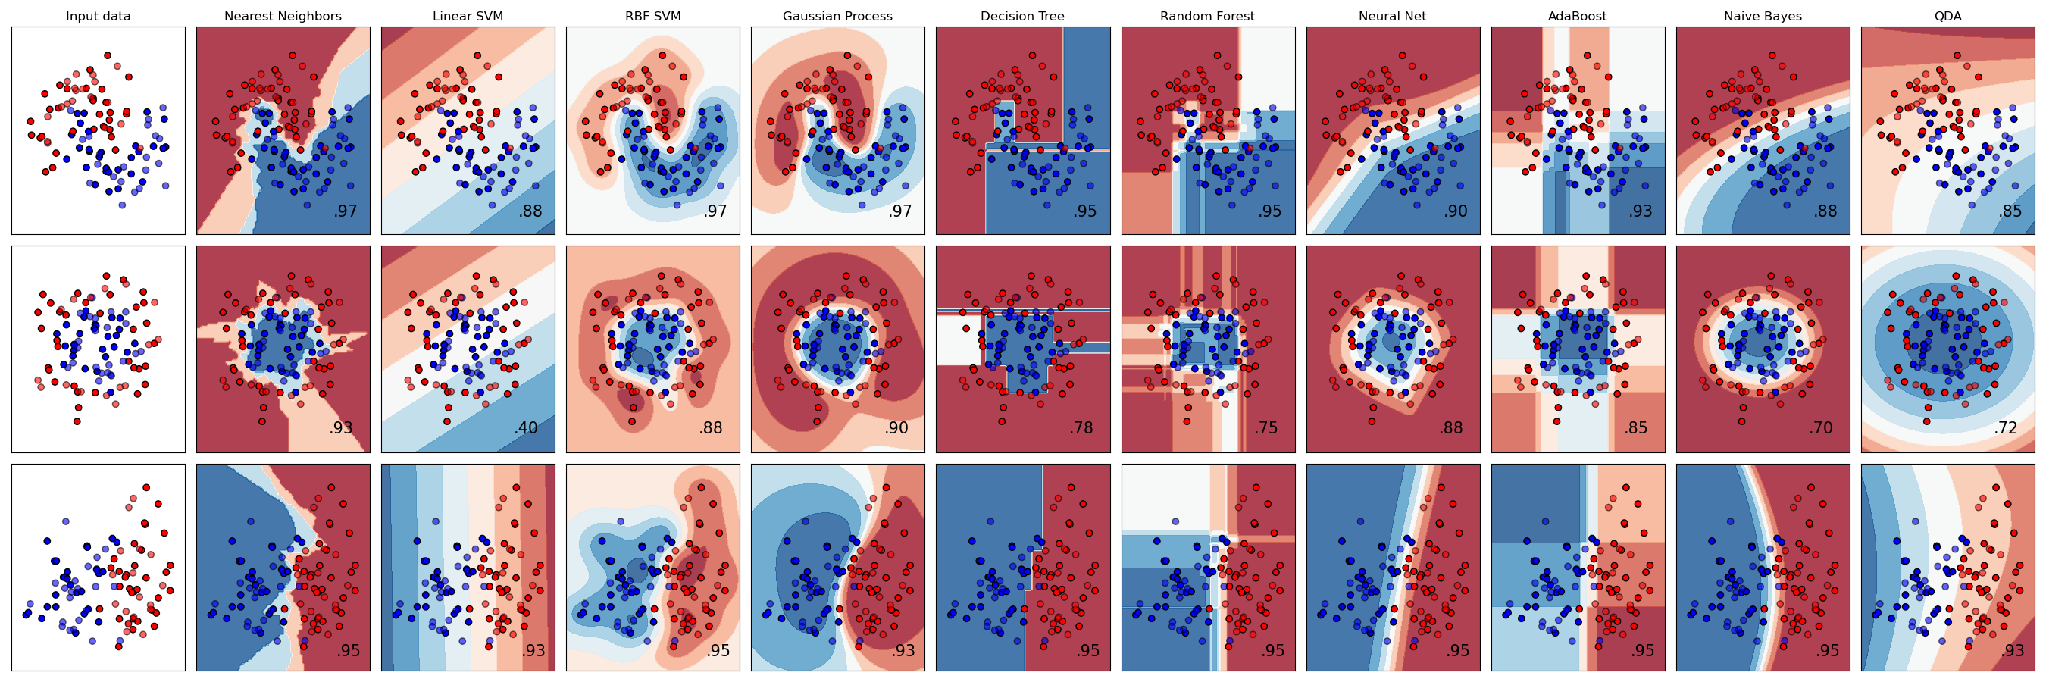
Линейная модель может провести только прямую линию (или плоскую гиперплоскость). Деревья же дробят пространство на прямоугольные области (ступеньки).
Bias–Variance (смещение и разброс)
У линейных моделей высокое смещение (bias) и низкий разброс (variance). Они слишком простые, чтобы идеально выучить сложные данные, но зато они стабильны и не сильно меняют свои предсказания на новых данных.
У бустинга — низкое смещение (может выучить любую сложную загогулину в данных), но он склонен к высокому разбросу (переобучению), если его не контролировать.
Требования к предобработке
Линейные модели капризны. При значительно разных масштабах признаков оптимизация может сходиться хуже, а регуляризация воздействует на коэффициенты неравномерно. Поэтому признаки часто масштабируют (StandardScaler). Бустингу это не интересно: для дерева вопрос «Зарплата > 1 000 000?» работает так же хорошо, как «Зарплата_scaled > 2,5?».
Поведение за пределами обучающей выборки (экстраполяция)
Это критическое отличие. Линейная модель знает уравнение прямой. Если вы попросите предсказать значение для данных, которых она никогда не видела (далеко за пределами трейна), она просто продолжит прямую линию. Дерево так не умеет. Дерево скажет: «Самое большое значение, что я видел — это 100. Значит, все, что больше, тоже будет 100».
Где линейные модели лучше бустинга?
Вот мы и добрались до мякоти. В каких реальных бизнес-задачах вам стоит отложить LightGBM в сторону и импортировать LogisticRegression?
1. Мало данных и много признаков (p ≫ n)
В статистике есть термин проклятие размерности. Представьте, что у вас есть данные по генетике: всего 100 пациентов (строк), но у каждого измерено 20 000 генов (признаков). Бустинг в этом датасете моментально найдет ген, который идеально разделит 100 человек на больных и здоровых просто по случайному совпадению шума. Деревья мгновенно переобучатся. Линейная модель с сильной L1-регуляризацией (Lasso) в такой ситуации сработает идеально и не переобучается на шуме. Она отсортирует 19 990 бесполезных генов и оставит только те 10, которые действительно имеют линейную связь с болезнью.
2. Разреженные высокоразмерные данные (тексты, TF-IDF)
Когда мы работаем с текстами классическими методами (Bag of Words, TF-IDF), мы превращаем текст в таблицу, где колонки — это все слова словаря (их могут быть сотни тысяч), а в ячейках стоят нули (если слова в тексте нет) и редкие единицы. Это называется разреженной матрицей (Sparse Matrix). Деревья ненавидят разреженные данные. Делать сплит (разбиение) по признаку, который в 99% случаев равен нулю, алгоритмически невыгодно – прирост информации (Information Gain) мизерный. Линейная модель (особенно линейный SVM или логистическая регрессия) обожает такие данные. Она просто присвоит каждому слову свой вес: слово «скидка» получит вес +5 к классу «спам», а слово «отчет» — вес −3. Это работает феноменально быстро и точно.
3. Необходимость экстраполяции (прогнозирование трендов)
Как мы уже разобрали на диаграмме выше, деревья не умеют экстраполировать. Если вы прогнозируете продажи интернет-магазина, который растет на 20% каждый год, бустинг на деревьях не продолжит этот линейный тренд за пределы обучающего диапазона так, как линейная регрессия. Линейная регрессия легко улавливает линейный тренд и продолжает его в будущее. На практике часто используют гибрид: линейная модель предсказывает общий тренд роста, а бустинг предсказывает отклонения от этого тренда (сезонность, праздники).
4. Жесткие требования к интерпретируемости и регуляторике
В банковском скоринге вы не можете сказать клиенту: «Вам отказано в ипотеке, потому что так решило 345-е дерево в ансамбле XGBoost на глубине 4». По законам многих стран вы обязаны объяснить причину. Линейная модель абсолютно прозрачна. Вы берете веса модели и переводите их в баллы (Scorecard).
Пример. Базовый балл = 50. Зарплата > 100 тысяч? Плюс 20 баллов. Были просрочки? Минус 40 баллов. Итого: 30 баллов. Порог 50. Отказ. Все кристально ясно, и это легко согласовать с риск-менеджерами и регулятором.
5. Жесткие требования к задержке и ограничения по памяти
Представьте систему RTB (Real-Time Bidding) — показ рекламы в интернете. Когда вы открываете страницу, у системы есть около 50 миллисекунд, чтобы оценить вероятность вашего клика по миллиону рекламных баннеров и выбрать лучший. Инференс (предсказание) линейной модели — это просто скалярное произведение двух векторов (перемножили числа и сложили). Операция выполняется за наносекунды на уровне процессора. Инференс бустинга — это проход по сотням деревьев, проверка условий if-else в каждом узле. Это на порядки медленнее. Кроме того, веса линейной модели весят килобайты, а ансамбль бустинга может занимать сотни мегабайт оперативной памяти, что критично для edge-устройств (например, умных часов или IoT-датчиков).
6. Онлайн- и инкрементальное обучение
Что делать, если данные генерируются терабайтами в день и не влезают в оперативную память? Деревья требуют, чтобы все данные (или их значимая часть) были доступны для поиска оптимальных разбиений. Линейные модели можно обучать на лету с помощью стохастического градиентного спуска (SGD). Пришел один новый пример → модель обновила веса → пример удалился. Знаменитая библиотека Vowpal Wabbit построена на этом принципе и до сих пор является стандартом индустрии для высоконагруженных систем рекомендаций и рекламы.
7. Калибровка вероятностей
Логистическая регрессия, оптимизирующая LogLoss, часто дает хорошо откалиброванные вероятности, особенно если модель корректно специфицирована и регуляризация подобрана. Для хорошо откалиброванной модели прогноз 0,8 означает, что среди объектов с такой оценкой около 80% относятся к положительному классу. Бустинги часто выдают искаженные вероятности (смещенные к 0 или 1 в зависимости от баланса классов), и их приходится дополнительно калибровать (Platt scaling, Isotonic regression). В задачах, где важна именно точная вероятность (например, расчет математического ожидания прибыли), логистическая регрессия часто выступает надежным базисом.
Где бустинг все-таки выигрывает?
Чтобы статья не выглядела как слепая ода линейным моделям, давайте обозначим, где бустинг разрывает их в клочья.
- Сложные нелинейности и взаимодействия признаков. Если вероятность дефолта высока у молодых людей с низким доходом и у пожилых людей с высоким доходом, линейной модели придется туго. Вам придется вручную создавать новые признаки (Feature Engineering), перемножать колонки, возводить в квадрат. Бустинг найдет эти зависимости сам.
- Разнородные табличные данные. Когда в одной таблице смешаны возраст, рост, зарплата, бинарные флаги и категориальные ID городов. Бустинг примет это без проблем.
- Пропуски (NaN) и категории. Современные библиотеки бустинга умеют работать с пропусками и категориальными признаками, но интерфейсы различаются: CatBoost поддерживает строковые категории напрямую, а LightGBM ожидает категориальные признаки в поддерживаемом представлении. Линейная модель упадет с ошибкой — ей нужны только числа, пропуски придется заполнять (импутация), а категории кодировать (One-Hot Encoding).
- Устойчивость к выбросам. Если у одного клиента в базе ошибка и его возраст указан как 999 лет, линейная регрессия сойдет с ума, пытаясь минимизировать квадрат ошибки, и сильно исказит веса. Дерево просто отправит его в лист «Возраст > 60» и забудет.
Практическая часть: сравниваем на реальных задачах (Python)
Меньше слов, больше кода! Давайте проведем три эксперимента, используя scikit-learn и LightGBM.
Установите библиотеки, если будете повторять:
pip install scikit-learn lightgbm pandas numpy
Численные результаты ниже приведены как пример: они могут отличаться в зависимости от версий библиотек и окружения.
Эксперимент 1: классификация текстов (разреженные данные)
Возьмем датасет новостей и попробуем отличить тему «Космос» от темы «Медицина».
import time
import numpy as np
from sklearn.datasets import fetch_20newsgroups
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from lightgbm import LGBMClassifier
from sklearn.metrics import accuracy_score

# Загружаем данные (2 класса для скорости)
cats = ['sci.med', 'sci.space']
train = fetch_20newsgroups(subset='train', categories=cats)
test = fetch_20newsgroups(subset='test', categories=cats)

# Превращаем текст в разреженную матрицу TF-IDF
vectorizer = TfidfVectorizer(max_features=10000)
X_train = vectorizer.fit_transform(train.data)
X_test = vectorizer.transform(test.data)
y_train, y_test = train.target, test.target

print(f"Размерность данных: {X_train.shape}") # (1187, 10000) - p >> n!

# 1. Линейная модель (Логистическая регрессия)
start = time.time()
lr = LogisticRegression(C=1.0, solver='liblinear')
lr.fit(X_train, y_train)
lr_time = time.time() - start
lr_pred = lr.predict(X_test)

# 2. LightGBM
start = time.time()
# LightGBM поддерживает scipy.sparse; приводим значения к float32
lgbm = LGBMClassifier(n_estimators=100, random_state=42)
lgbm.fit(X_train.astype(np.float32), y_train)
lgbm_time = time.time() - start
lgbm_pred = lgbm.predict(X_test.astype(np.float32))

print(f"LogReg: Accuracy = {accuracy_score(y_test, lr_pred):.4f}, Time = {lr_time:.3f} sec")
print(f"LGBM:   Accuracy = {accuracy_score(y_test, lgbm_pred):.4f}, Time = {lgbm_time:.3f} sec")
Ожидаемый вывод:
Размерность данных: (1187, 10000)
LogReg: Accuracy = 0.9835, Time = 0.021 sec
LGBM: Accuracy = 0.9544, Time = 1.450 sec
В этом запуске линейная модель обучилась примерно в 70 раз быстрее и показала более высокую Accuracy. На другом окружении соотношение может отличаться.
Эксперимент 2: маленький табличный датасет с нелинейностями
Возьмем классическую задачу классификации вина по его химическому составу.
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

data = load_wine()
X_train, X_test, y_train, y_test = train_test_split(data.data, data.target, test_size=0.3, random_state=42)

# Для линейной модели обязательно масштабируем признаки!
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# LogReg
lr = LogisticRegression(max_iter=1000)
lr.fit(X_train_scaled, y_train)
print(f"LogReg Accuracy: {accuracy_score(y_test, lr.predict(X_test_scaled)):.4f}")

# LGBM (кормим сырые немасштабированные данные)
lgbm = LGBMClassifier(n_estimators=50, random_state=42)
lgbm.fit(X_train, y_train)
print(f"LGBM Accuracy: {accuracy_score(y_test, lgbm.predict(X_test)):.4f}")
Ожидаемый вывод:
LogReg Accuracy: 0.9815
LGBM Accuracy: 0.9444
На датасетах, где мало строк (здесь их всего около 170), бустинг склонен к переобучению, даже несмотря на свою мощь. Линейная модель, будучи более «жесткой», обобщает лучше.
Эксперимент 3: проблема экстраполяции (тренд)
Покажем, как модели предсказывают будущее.
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from lightgbm import LGBMRegressor

# Генерируем данные с линейным трендом + шум
np.random.seed(42)

X = np.linspace(0, 100, 1000).reshape(-1, 1)
y = 2 * X.ravel() + 10 + np.random.normal(0, 10, 1000)

# Обучаем на первой половине (от 0 до 50)
X_train, y_train = X[:500], y[:500]
# Тестируем на второй половине (от 50 до 100) - будущее
X_test, y_test = X[500:], y[500:]

lr = LinearRegression().fit(X_train, y_train)
lgbm = LGBMRegressor(n_estimators=50).fit(X_train, y_train)

print(f"Значение линейного тренда в точке 100: 210")
print(f"Предсказание Linear: {lr.predict([[100]])[0]:.0f}")
print(f"Предсказание LGBM:   {lgbm.predict([[100]])[0]:.0f}")
Ожидаемый вывод:
Реальное значение в точке 100: ~210
Предсказание Linear: 211
Предсказание LGBM: 108
За пределами обучающего диапазона бустинг в этом примере дает почти постоянный прогноз, потому что новые значения X попадают в крайние листья деревьев. Линейная модель продолжает заложенный в данных линейный тренд.
Как выбрать модель под задачу
Чтобы вам было проще принимать решения на практике, я составил небольшую блок-схему принятия решений.
Гибридные подходы (лучшее из двух миров)
Продвинутые ML-инженеры часто не выбирают что-то одно, а комбинируют подходы:
- Линейная модель как бейзлайн (Baseline). Для классификации можно начать с логистической регрессии. Это займет пять минут, но даст вам базовую метрику. Если бустинг потом покажет прирост всего на 0,001 AUC, возможно, усложнять систему не стоит.
- Стекинг (Stacking). Вы обучаете и бустинг, и линейную модель, а затем обучаете еще одну модель (мета-модель, часто тоже линейную), которая принимает предсказания первых двух и выдает финальный ответ.
- GLM поверх признаков из деревьев. Очень старый, но крутой трюк: обучаем деревья, берем индексы листьев, в которые попал объект, делаем из них One-Hot Encoding и кормим в логистическую регрессию. Получаем нелинейность от деревьев и быструю вероятностную оценку от регрессии.
Градиентный бустинг или линейная модель: коротко
Градиентный бустинг — это мощнейший инструмент, который действительно доминирует на соревнованиях и в большинстве стандартных бизнес-задач с табличными данными. Но машинное обучение — это не только пробитие потолка метрик на Kaggle. Это инженерия.
Настоящий Senior ML-инженер отличается от джуниора тем, что понимает анатомию алгоритмов. Он знает, что для разреженных текстов, потокового онлайна, жесткого latency или задач с экстраполяцией тяжелый ансамбль деревьев станет обузой.
Линейные модели — это база. Они красивы математически, быстры в продакшене и абсолютно прозрачны. Не забывайте про них, начинайте свои эксперименты с них, и ваш код скажет вам спасибо!