

По цифрам в таблице можно понять, какие товары пользуются спросом, могут ли клиенты уйти к конкурентам, сколько заказов будет в следующем месяце. Находить такие закономерности и строить прогнозы — одна из задач специалистов по Data Science. В статье рассказываем, что учить новичку, чтобы работать с данными.
Зачем нужен Python в Data Science
Data Scientist — это специалист по работе с данными. Он помогает бизнесу находить закономерности, проверять гипотезы, делать прогнозы. Например, может анализировать продажи и сказать, какие товары лучше вывести из оборота, или рассчитать, сколько клиентов заинтересует подписка на новый сервис.
Чаще всего дата-сайентисты используют для работы Python — он позволяет решать большинство задач готовыми инструментами, не разрабатывая алгоритмы с нуля. С его помощью можно:
- собирать данные из файлов, баз данных и API;
- готовить данные к анализу — исправлять ошибки, обрабатывать пропуски, удалять дубликаты, приводить данные к нужному формату;
- рассчитывать показатели, сравнивать разные группы и проверять гипотезы;
- визуализировать данные, строить графики и диаграммы;
- обучать модели, которые делают прогнозы или распределяют объекты по категориям.
Сегодня Python — один из самых популярных языков программирования. По данным Stack Overflow, его используют 57,9% разработчиков. Чаще всего Python применяют в анализе данных, машинном обучении, разработке ИИ.
Что учить дата-сайентисту
Для работы с данными нужно знание синтаксиса и библиотек. Разберем, что учить на каждом этапе.
Шаг 1. Основы Python
Чтобы писать программы для обработки данных, нужно знать:
- Переменные и типы данных (int, float, str, bool). Они позволяют хранить числа, текст и логические значения. Например, цену заказа можно записать как float, а название товара — как str.
- Списки и словари. Списки хранят наборы значений, а словари связывают значения с ключами. С их помощью можно собрать цены нескольких заказов или сохранить данные о клиенте.
- Условия (if). Позволяют выполнять разные действия в зависимости от значения. Например, можно проверить, превышает ли сумма заказа заданный порог.
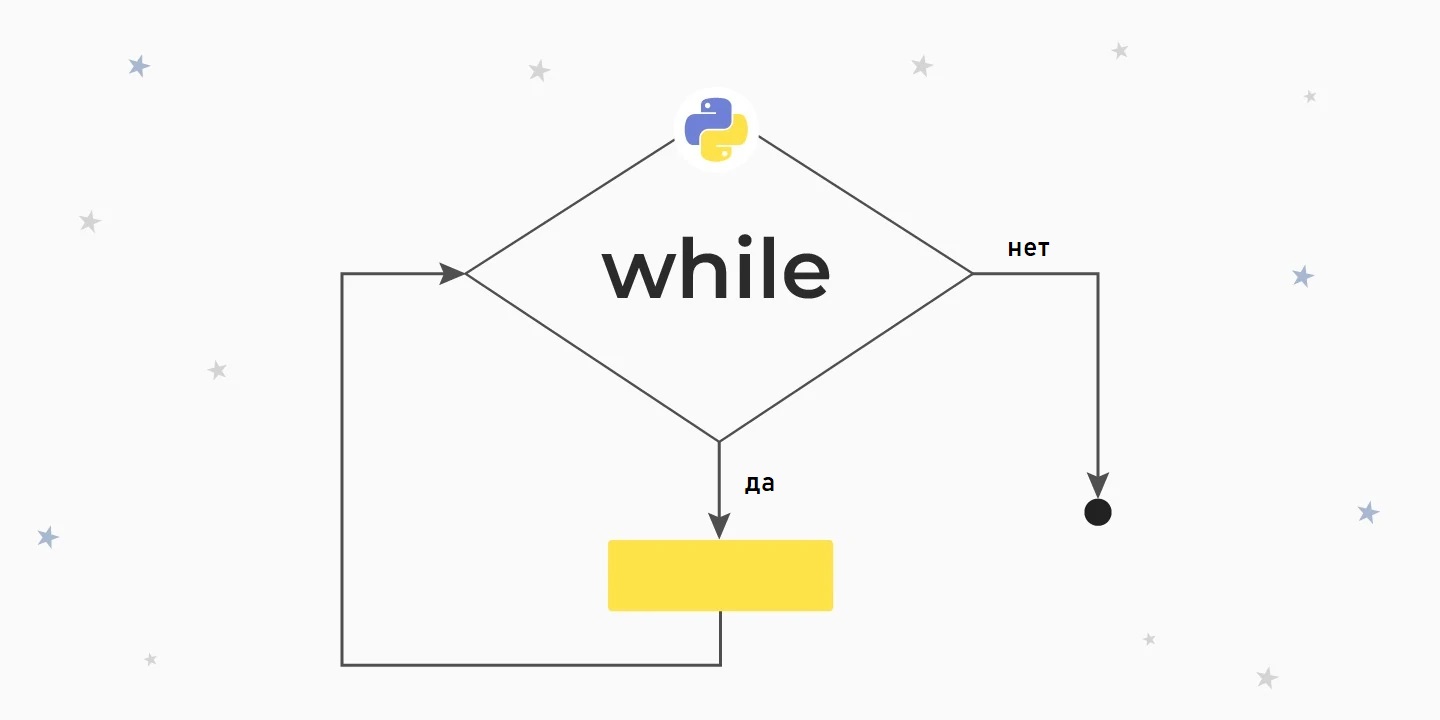
- Циклы (for, while). Повторяют действия для нескольких элементов или пока выполняется заданное условие. Цикл for может рассчитать стоимость каждого заказа в списке, а while будет повторять расчет, пока не обработает все заказы.
- Функции. Позволяют оформить повторяющийся расчет в отдельный блок кода. Достаточно один раз написать функцию расчета скидки, чтобы применять ее к разным заказам.
Эти конструкции пригодятся при работе с данными, например чтобы сравнить показатели или отобрать записи по заданным условиям. Когда освоите их, можно переходить к библиотекам для обработки и анализа данных.
Шаг 2. Работа с данными
Чаще всего дата-сайентистыработают с таблицами, состоящими из тысяч строк. Чтобы обрабатывать такие данные, используют библиотеки:
- Pandas — для работы с таблицами. Позволяет загружать данные из CSV и Excel, выбирать строки и столбцы, фильтровать записи, обрабатывать пропуски и дубликаты, группировать данные и объединять таблицы.
- NumPy — для работы с числовыми массивами. Может выполнять математические операции сразу над множеством значений и обрабатывать многомерные массивы.
Например, с помощью Pandas можно загрузить список заказов и рассчитать выручку по каждой категории. А NumPy пригодится, если нужно применить расчет скидки сразу к массиву цен на тысячу товаров.
Предположим, у интернет-магазина есть три заказа — два на книги и один на бытовую технику. В Pandas можно сгруппировать заказы по категориям и посчитать выручку:
import pandas as pd
orders = pd.DataFrame({
    "category": ["Книги", "Техника", "Книги"],
    "amount": [1200, 5000, 800]
})
revenue = orders.groupby("category")["amount"].sum()
print(revenue)
Результат:
category
Книги       2000
Техника     5000
Name: amount, dtype: int64
Метод groupby() группирует строки с одинаковой категорией, а sum() складывает суммы заказов внутри каждой группы.
Шаг 3. Визуализация данных
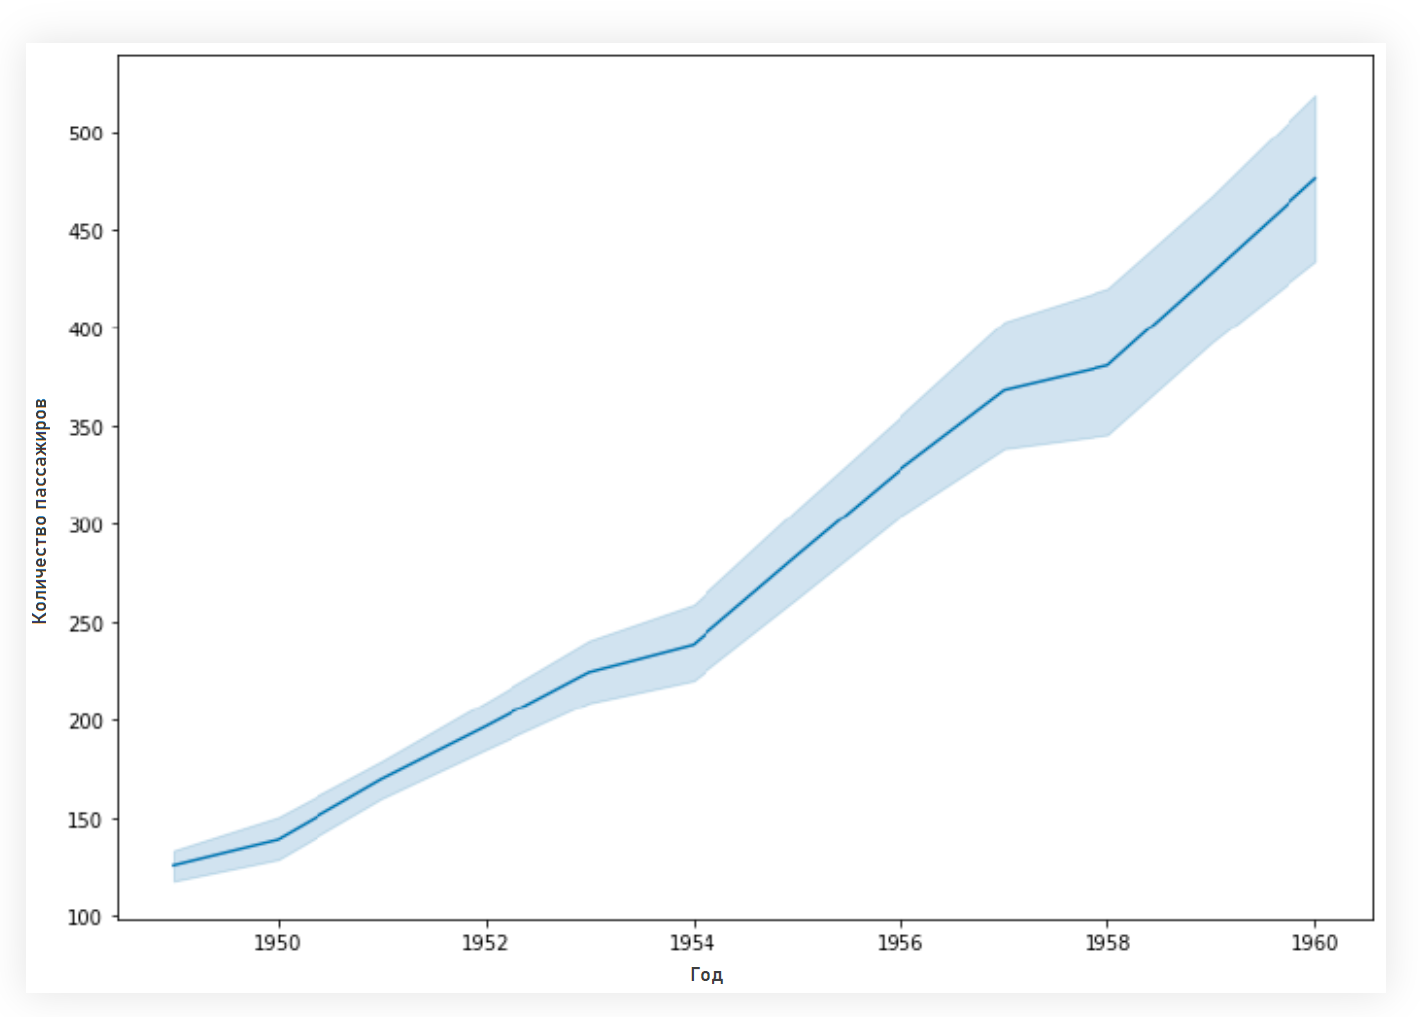
Графики помогают быстрее находить закономерности, сравнивать показатели и замечать аномалии. Для визуализации в Python понадобятся библиотеки:
- Matplotlib — для построения базовых графиков: линейных, столбчатых, гистограмм и диаграмм рассеяния.
- Seaborn — для статистической визуализации. Библиотека упрощает построение графиков распределений и тепловых карт корреляционных матриц, а также сравнение нескольких групп.
Например, с помощью Matplotlib можно построить график выручки по месяцам и увидеть сезонные колебания. А Seaborn поможет сравнить распределение чеков в разных категориях товаров или оценить связь между стоимостью заказа и количеством позиций.
Шаг 4. Статистика и анализ данных
Статистика помогает понять, что происходит с процессами внутри компании. На этом этапе важно изучить:
- Среднее и медиану — они показывают типичное значение в наборе данных. Например, по среднему чеку можно оценить среднюю сумму заказа, а по медиане — понять, сколько обычно тратит покупатель, если отдельные крупные заказы искажают среднее.
- Разброс и процентили — помогают оценить, насколько сильно значения отличаются друг от друга и ниже какого значения находится заданная доля наблюдений.
- Распределения — показывают, какие значения встречаются чаще, а какие — редко. Например, можно изучить распределение времени доставки или сумм заказов.
- Корреляцию — помогает найти связь между двумя разными показателями. Можно увидеть, как количество позиций связано со стоимостью заказа или как рекламные расходы связаны с количеством клиентов.
- Проверку гипотез — помогает оценить, насколько наблюдаемые различия между группами согласуются с проверяемой гипотезой. Например, можно проверить, насколько вероятно получить наблюдаемую разницу в среднем чеке, если скидка не изменила его.
В Python статистические расчеты выполняют с помощью уже знакомых библиотек Pandas и NumPy. Предположим, нам нужно сравнить средний чек в двух регионах. Можно сгруппировать заказы и рассчитать среднее значение:
import pandas as pd

orders = pd.DataFrame({
    "region": ["Север", "Юг", "Север", "Юг", "Север"],
    "amount": [1200, 900, 1800, 1500, 1000]
})

print(orders.groupby("region")["amount"].mean())
Результат:
region
Север    1333.333333
Юг       1200.000000
Name: amount, dtype: float64
В этом примере средний чек на Севере выше. Но по пяти заказам нельзя делать вывод о типичных тратах покупателей в регионах. Чтобы понять, сколько обычно тратят покупатели и насколько сильно отличаются суммы заказов, стоит дополнительно рассчитать медиану и оценить разброс значений.
Шаг 5. Основы машинного обучения
С помощью машинного обучения можно создавать модели, которые находят закономерности в данных, делают прогнозы или занимаются классификацией.
Для первых экспериментов с моделями подойдет библиотека scikit-learn. Начинающим специалистам нужно изучить:
- Признаки и целевую переменную. Признаки — этохарактеристики объектов, на основе которых модель делает прогноз, а целевая переменная — то, что нужно предсказать. Например, при прогнозировании стоимости квартиры признаками могут быть площадь и район, а целевой переменной — цена.
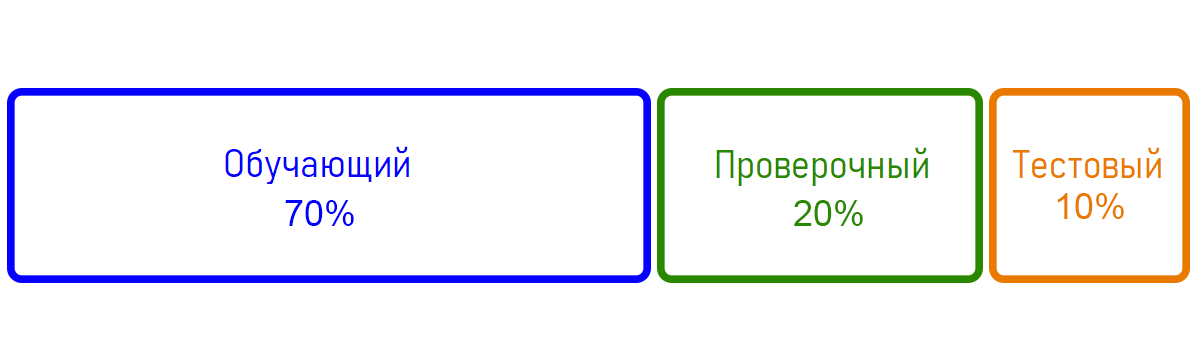
- Разделение данных. Данные можно разделить на обучающую, валидационную и тестовую выборку, чтобы проверить, насколько хорошо модель работает с данными, которые раньше не видела. Для настройки модели также используют кросс-валидацию.
- Процесс обучения модели. Нейросеть находит закономерности на примерах из обучающей выборки, чтобы затем применить их к новым данным.
- Метрики качества. Позволяют оценить, насколько хорошо модель справляется с задачей. Например, для классификации можно посчитать долю правильных ответов, для прогноза цены — сравнить предсказанные значения с реальными и рассчитать среднюю абсолютную ошибку.
- Переобучение. Возникает, когда модель слишком хорошо подстраивается под обучающие данные, но хуже работает на новых примерах.
Модели помогают бизнесу принимать важные решения: прогнозировать спрос, анализировать риски, лучше понимать поведение клиентов. Поэтому важно уметь не только обучать модели, но и оценивать их качество.
Шаг 6. Инструменты для самостоятельной работы
Помимо Python и библиотек, дата-сайентисту нужны инструменты для работы с кодом:
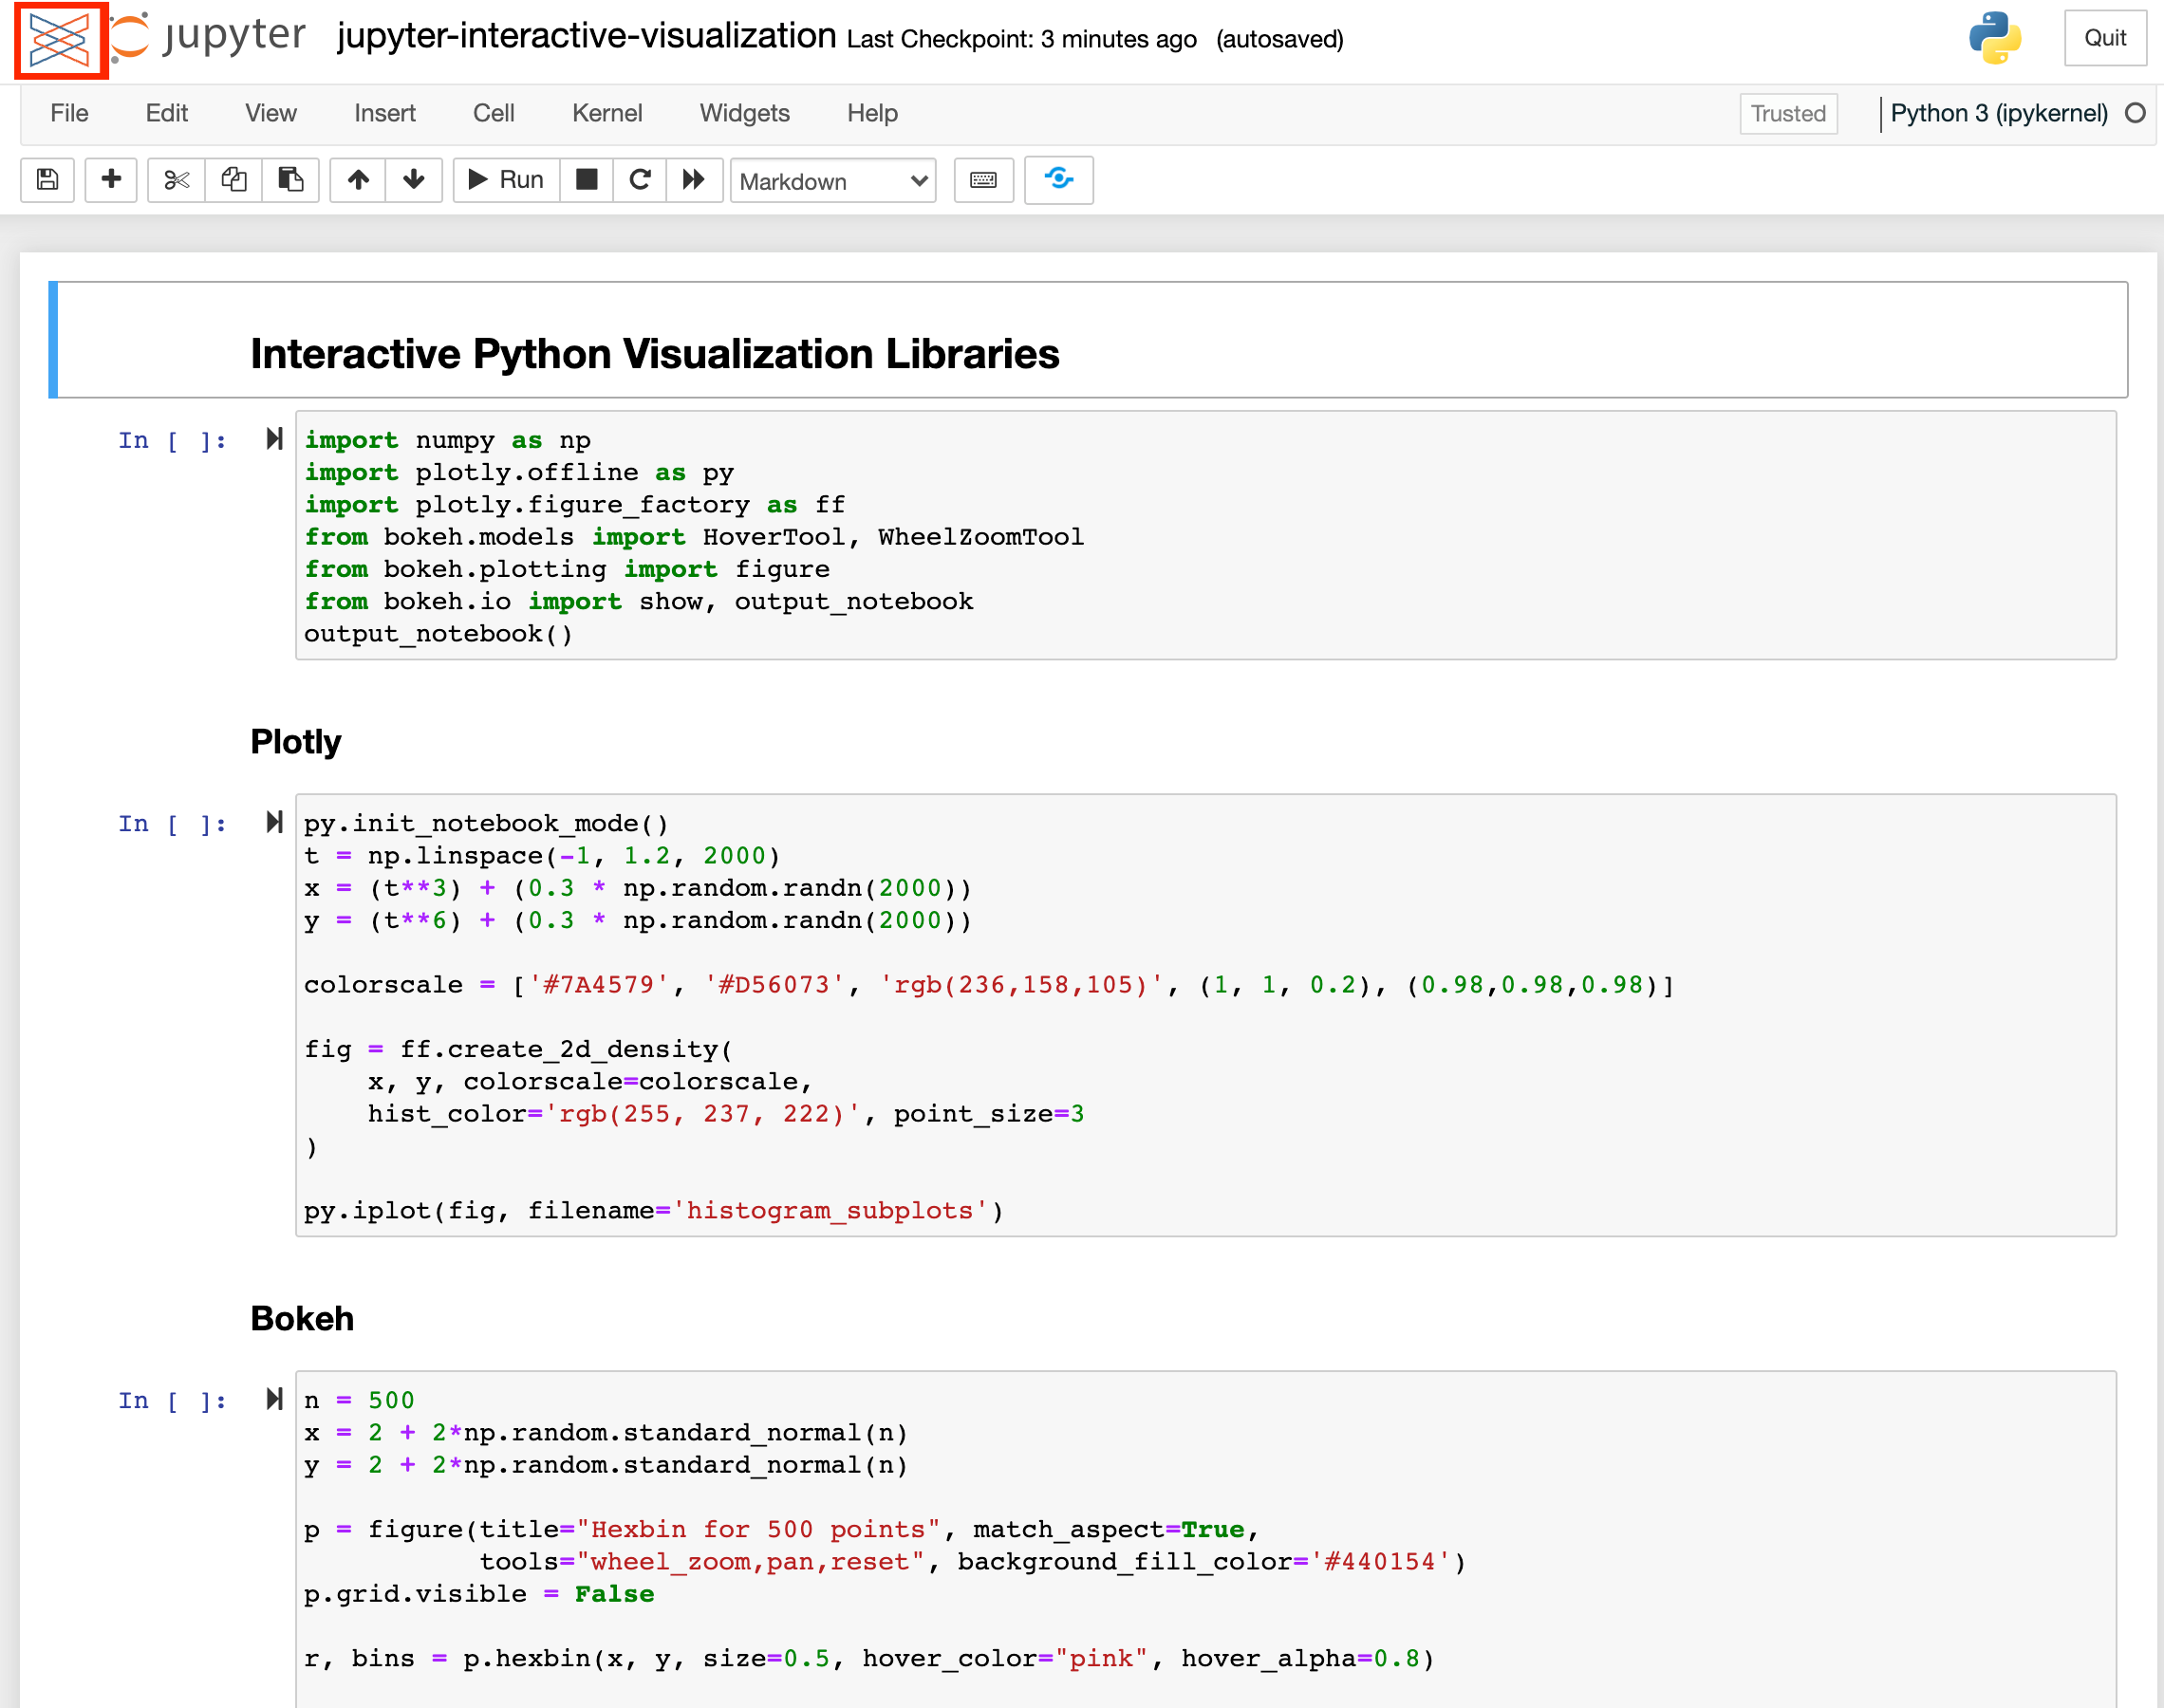
- Jupyter Notebook — интерактивная среда, в которой можно запускать код по частям, выводить таблицы и графики, добавлять пояснения. Ее можно использовать для исследования данных и первых экспериментов с моделями.
- Git — система контроля версий, которая позволяет фиксировать изменения кода в коммитах и возвращаться к предыдущим версиям.
- Виртуальные окружения — помогают изолировать зависимости разных проектов, чтобы версии библиотек не конфликтовали между собой.
Например, в Jupyter Notebook можно загрузить данные о продажах, обработать их с помощью Pandas, построить график и проверить гипотезу. Затем сохранить код в Git, чтобы отслеживать изменения и при необходимости восстановить предыдущую версию.
Типичные ошибки в Python
Начинающие программисты часто допускают ошибки при написании кода. Чтобы найти причину сбоя и исправить ее, обратите внимание на сообщения интерпретатора.
Не все ошибки Python обнаружит автоматически. Например, если в таблице есть дубликаты записей об одних и тех же заказах, сумма выручки окажется завышенной. Или, если даты записаны в разных форматах, программа может неверно сгруппировать продажи по месяцам. Поэтому кроме технической проверки кода нужно проверять и сами данные.
Какие ограничения есть у Python
Python подходит для большинства задач анализа данных, но не всегда является единственным или самым удобным инструментом.
- Большие объемы данных. Если таблица не помещается в оперативную память, обработка через Pandas может оказаться неэффективной. В зависимости от задачи можно выполнять вычисления в базе данных с помощью SQL или использовать инструменты вроде Apache Spark, которые распределяют обработку между несколькими компьютерами.
- Простые отчеты. Для регулярных сводок и интерактивных дашбордов может хватить Excel или BI-системы. Python полезен, если нужно автоматизировать сложные преобразования, объединять источники или повторять анализ регулярно по одному сценарию.
- Ограничения статистики. Корреляция показывает связь между показателями, но сама по себе не доказывает, что один показатель влияет на другой. Чтобы исследовать причинно-следственную связь, используют дополнительные методы анализа, например контролируемые эксперименты и A/B-тесты.
Python помогает автоматизировать анализ данных, но не гарантирует точность результатов. Важно понимать, какие данные нужны для конкретной задачи и как правильно их обработать.
Чек-лист дата-сайентиста
Проверьте, что вы уже можете делать самостоятельно:
- написать программу на Python — использовать переменные, условия, циклы и функции;
- обработать таблицу в Pandas — загрузить данные, отфильтровать строки, найти пропуски и посчитать показатели по группам;
- выполнить вычисления с NumPy — применить математическую операцию к массиву чисел;
- построить график — выбрать подходящий тип визуализации, подписать оси и объяснить, что показывает результат;
- рассчитать статистику — вычислить среднее и медиану, оценить разброс значений, проверить наличие корреляции между показателями;
- обучить простую модель — разделить данные на обучающую и тестовую выборки, обучить модель в scikit-learn и оценить ее качество на тестовой выборке;
- использовать Git — сохранить изменения в репозитории и посмотреть историю версий кода.
Если с большинством пунктов вы справились, переходите к более сложным задачам. Если трудности возникают уже на первых шагах, стоит разобраться в основах Python и последовательно освоить нужные инструменты.